
회사에 새 동료가 오면 우리끼리 쓰는 말부터 알려 줍니다. "정기권은 회원만 살 수 있다", "늦게 반납하면 5분마다 200원" 같은 것들이요. AI에게도 이런 사전을 주자는 것이 온톨로지입니다. 요즘 팔란티어 덕분에 정말 자주 들리는 말이죠.
시작은 한 구독자분이 보내 주신 실험이었습니다. 코딩 AI에 기획서(PRD)와 설계서(SDD)를 넣었더니 온톨로지는 별 쓸모가 없었고, 토큰과 시간은 오히려 온톨로지가 없는 쪽이 적었다는 내용이었습니다. 정말 그런지, 성격이 다른 두 곳에서 직접 재 봤습니다.
이 글에서는 다음을 차례로 봅니다.
- 온톨로지는 무엇이고, 비슷한 말과 무엇이 다른가
- 잘 쓰는 곳과, 코딩 스펙(PRD·SDD)과 겹치는 곳
- 실험 1: 작은 코딩 과제(따릉이 요금 모듈)
- 실험 2: 도메인이 두꺼운 보험 회사 데이터 챗봇
- 언제 쓰고, 어떻게 시작하면 되나
숫자 읽는 법. [공식 문서] 는 회사·표준 기관이 직접 낸 자료, [논문] 은 공개 논문, [직접 측정] 은 저희가 Claude Code(모델 Sonnet)로 직접 돌려 잰 숫자입니다. 실험 코드와 결과 파일은 글 끝 저장소에 모두 있습니다.
1. 온톨로지란
온톨로지라는 말은 원래 철학에서 왔습니다. 무엇이 존재하는지를 따지는 분야입니다. 컴퓨터 쪽에서는 1993년 톰 그루버의 정의가 가장 많이 쓰입니다. "개념화를 명시적으로 적은 명세" [논문] (Gruber 1993).
쉽게 말하면 한 분야에 무엇이 있고 서로 어떻게 이어지는지를, 기계도 읽을 수 있게 적어 둔 것입니다. 관계와 규칙이 붙은 사전이라고 생각하면 됩니다. 따릉이 요금으로 예를 들면 네 가지를 적습니다.
- 개념: 이용권, 그 아래 일일권과 정기권
- 속성: 이용권마다 가격과 기본대여시간
- 관계: 사용자가 이용권을 살 수 있다
- 규칙: 기본대여시간을 넘기면 5분마다 200원, 정기권은 회원만 살 수 있다 [공식 문서] (따릉이 이용권 안내, 2026-10-28 확인)
비슷한 말과의 차이
헷갈리는 말들을 계단으로 놓으면 쉽습니다.
| 칸 | 담는 것 | 예 |
|---|---|---|
| 용어집 | 낱말 뜻 | 정기권 = 기간 동안 쓰는 이용권 |
| 분류 체계 | 위아래 묶음 | 이용권 → 일일권·정기권 |
| 온톨로지 | 위 두 가지 + 관계·규칙 | 넘기면 5분마다 200원 |
| 지식 그래프 | 온톨로지라는 틀에 채운 실제 사실 | 대여 기록 수백만 건 |
웹 표준을 만드는 W3C 문서도 이 차이를 짚습니다. 분류 체계나 시소러스는 규칙이나 사실을 주장하지 않는다는 것입니다 [공식 문서] (W3C SKOS). 정리하면 온톨로지는 틀이고, 지식 그래프는 그 틀에 담긴 데이터입니다.
2. 잘 쓰는 곳, 그리고 스펙과 겹치는 곳
잘 쓰는 곳
- 팔란티어: 문서에서 온톨로지를 조직의 디지털 트윈이라고 부릅니다. 재료는 객체 타입, 속성, 링크 타입, 액션 타입 네 가지입니다. 항공편이 객체라면 출발 시각은 속성, 항공편과 공항을 잇는 것이 링크, 일정 바꾸기가 액션입니다 [공식 문서] (Palantir Foundry Ontology).
- 구글: 2012년 검색에 지식 그래프를 붙였습니다. "글자가 아니라 사물을 찾자"는 것이었고, 발표 당시 개체 5억 개, 사실 35억 개가 넘었습니다 [공식 문서] (Google 블로그).
- 효과를 잰 연구: 2023년 보험 회사 데이터베이스 실험에서 GPT-4에게 SQL로 바로 물으면 정답률 16%, 같은 데이터를 온톨로지 기반 지식 그래프로 바꿔 물으면 54%였습니다 [논문] (Sequeda·Allemang·Jacob 2023).
공통점은 두 가지입니다. 여러 사람과 시스템이 같은 말을 써야 하는 곳, 그리고 데이터 사이의 관계를 물어야 하는 곳입니다.
코딩 스펙과 겹치는 곳
AI 코딩에서는 보통 문서 두 개를 먼저 씁니다. PRD(제품 요구사항 문서)는 무엇을 왜 만드는지, SDD(스펙 주도 개발)의 설계 스펙은 어떻게 만들지 적습니다. 깃허브의 Spec Kit 스펙 양식에는 Key Entities 칸이 있습니다. 다루는 대상이 무엇이고 다른 대상과 어떤 관계인지 적는 칸입니다 [공식 문서] (GitHub Spec Kit).
이건 온톨로지의 개념과 관계입니다. 스펙 안에 이미 온톨로지 조각이 들어 있는 셈입니다. 그럼 둘 다 넣으면 더 좋을까요, 겹치기만 할까요?
3. 실험 1: 작은 코딩 과제
방법
- 과제: 따릉이 요금 모듈
fare.js만들기. 함수는 가격(price), 추가요금(extraFee), 살 수 있는지(canBuy) 세 개 - 지식 파일: 따릉이 안내 원본(
source.md)만 주고 Claude Code가ontology.md를 만들게 한 뒤, 같은 내용으로PRD.md·SDD.md도 쓰게 했습니다. 담긴 사실이 같아야 공정하니까요. - 조건 7개: 과제만 / +온톨로지 / +PRD·SDD / +둘 다 / +둘 다(한쪽만 옛 가격으로 어긋남) / +PRD·SDD+보이는 테스트 / +둘 다(가리키기, 아래에서 설명)
- 채점: 실행마다 빈 폴더에 그 조건의 파일만 넣고 같은 과제를 줍니다. 끝나면 AI가 볼 수 없는 숨은 테스트 28개로 채점합니다. 조건마다 3회.
결과
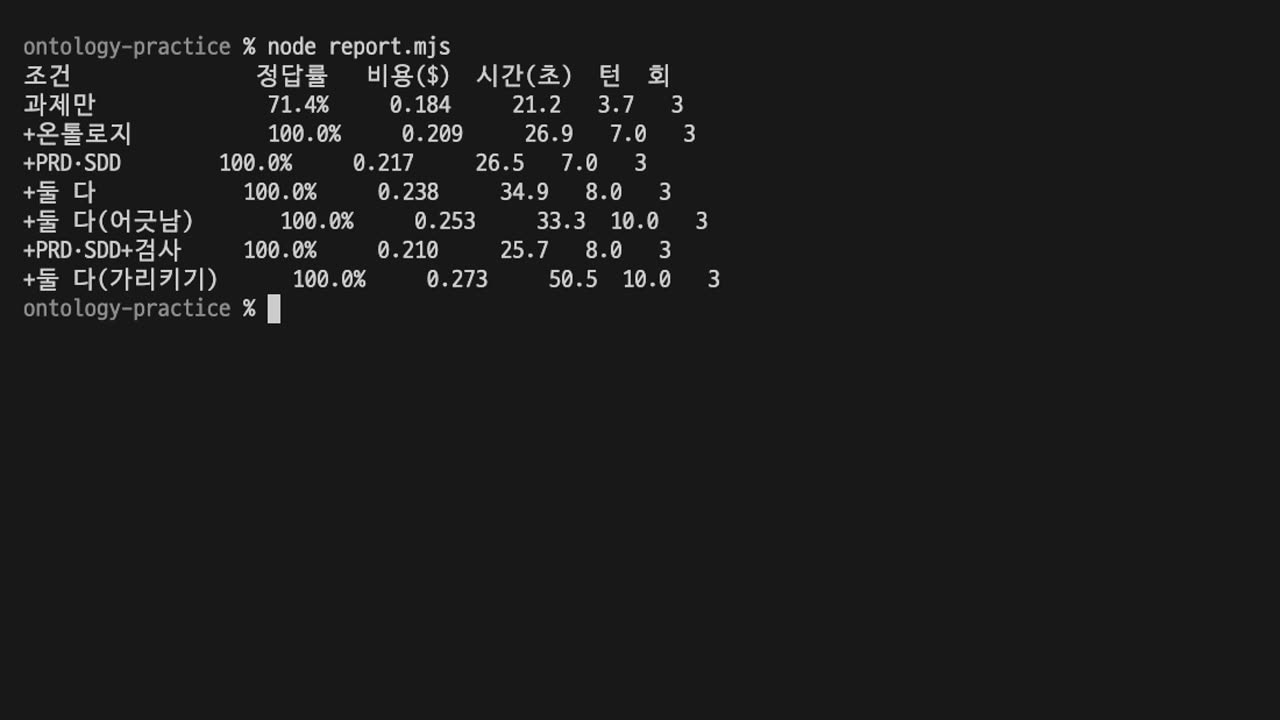
| 조건 | 정답률 | 한 번 비용($) | 시간(초) | 턴 |
|---|---|---|---|---|
| 과제만 | 71.4% | 0.184 | 21.2 | 3.7 |
| +온톨로지 | 100% | 0.209 | 26.9 | 7.0 |
| +PRD·SDD | 100% | 0.217 | 26.5 | 7.0 |
| +둘 다 | 100% | 0.238 | 34.9 | 8.0 |
| +둘 다(어긋남) | 100% | 0.253 | 33.3 | 10.0 |
| +PRD·SDD+검사 | 100% | 0.210 | 25.7 | 8.0 |
| +둘 다(가리키기) | 100% | 0.273 | 50.5 | 10.0 |
[직접 측정] 읽는 법은 이렇습니다.
- 지식을 하나라도 넣으면 만점입니다. 규칙을 알려 주는 것은 확실히 효과가 있습니다.
- 온톨로지만 넣든(0.209달러) 스펙만 넣든(0.217달러) 거의 같습니다.
- 둘 다 넣으면 하나만 넣을 때보다 비용이 10~14% 더 들고, 시간은 27초 안팎에서 35초로 30% 가까이 늘었습니다. 정답률은 그대로입니다. 구독자분 실험과 같은 방향입니다.
과제만 줬을 때: 그럴듯하게 지어낸다
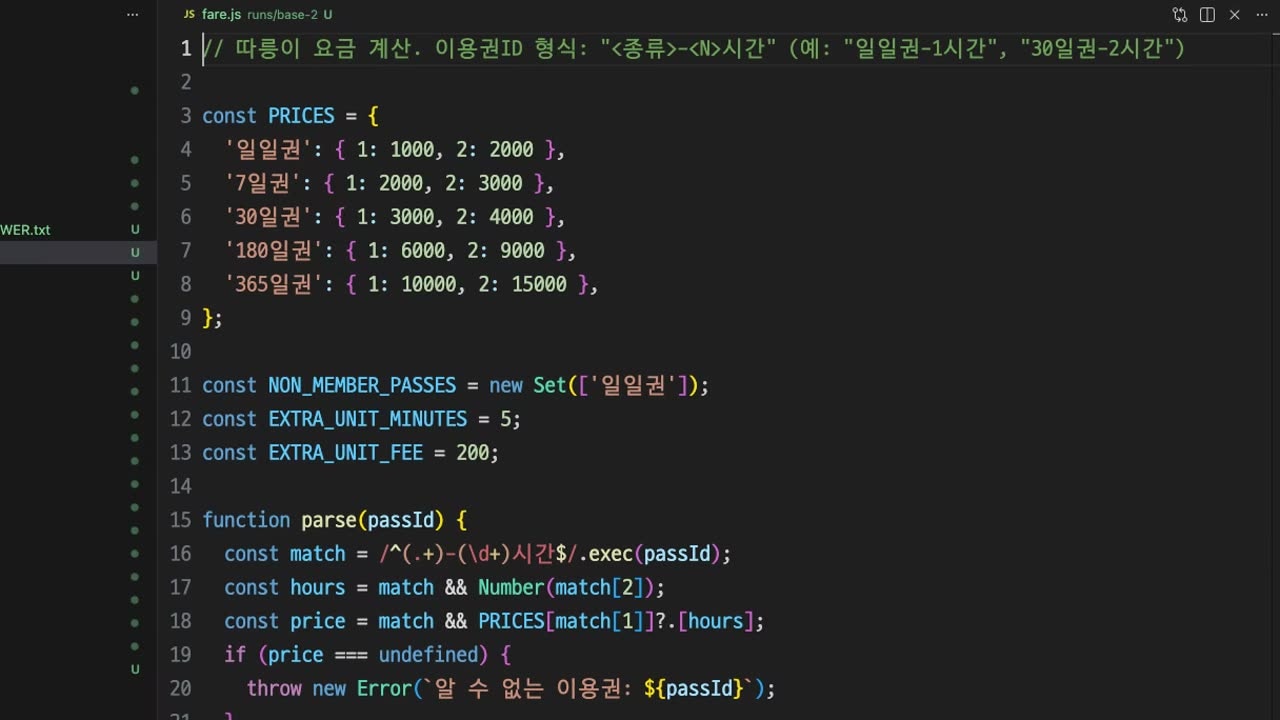
과제만 준 조건의 코드를 열어 보면 일일권에 3시간권이 없고, 정기권 가격은 7일권 2,000원, 365일권 10,000원처럼 지어낸 숫자입니다. 실제는 3,000원과 30,000원입니다. 모르는 규칙은 그럴듯하게 채워 넣는다, 지식 없이 시켰을 때 생기는 일입니다.
어긋남: 문서끼리 다르면 확인할 일이 늘어난다
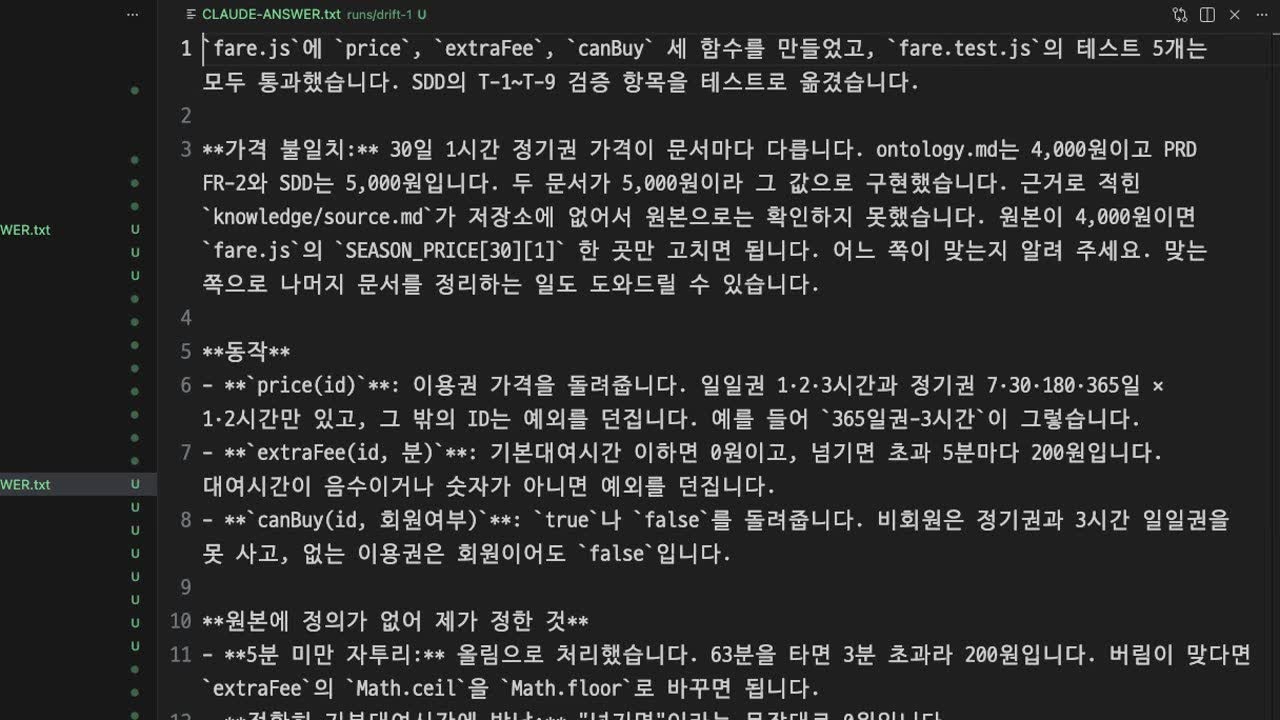
어긋남 조건에서는 ontology.md의 30일권 1시간권 가격만 일부러 4,000원으로 바꾸고 PRD·SDD는 5,000원으로 뒀습니다. Claude는 불일치를 짚고, 두 문서가 5,000원이라 그 값으로 구현했으니 어느 쪽이 맞는지 알려 달라고 했습니다. 이번엔 다수결이 맞았지만, 틀린 쪽이 둘이었다면 틀린 값을 골랐을 수도 있습니다. 이 조건은 턴이 평균 10번으로 가장 많았습니다.
가리키기의 함정
그럼 같은 사실을 한 곳에만 적고 나머지는 가리키게 하면 어떨까요? PRD·SDD에서 가격표와 규칙을 지우고 "ontology.md의 R7을 따른다"처럼 번호로 가리키게 고쳐서 다시 쟀습니다.
정답률은 100%였지만 비용 0.273달러, 시간 50.5초로 일곱 조건 중 가장 비쌌습니다. 고친 SDD에 "가격은 ontology.md 가격표를 유일한 출처로 쓴다. 코드나 이 문서에 값을 따로 옮겨 적지 않는다"는 줄이 생겼고, Claude는 이 말을 그대로 따라 실행할 때마다 ontology.md를 읽어 표를 잘라 내는 코드를 짰습니다. 설명용 문서가 프로그램의 부품이 된 것입니다. 표 모양이 조금만 바뀌어도 요금 계산이 깨질 수 있습니다.
값이 여러 곳에서 필요하다면 요금표를 JSON 파일 하나처럼 기계가 읽는 파일 한 곳에 두고, 코드·문서·테스트가 모두 그 파일을 쓰게 하는 쪽을 추천합니다. 이 방법은 이번에 재지 않았습니다.
큰 실험에서도 비슷하다
- 2026년 AGENTS.md 평가 논문: 저장소마다 컨텍스트 파일을 넣어 봤더니 성공률은 대체로 그대로였고, 추론 비용은 평균 20% 넘게 늘었습니다 [논문] (Gloaguen 외 2026).
- Chroma 실험: 18개 모델 모두 입력이 길어질수록 단순한 일도 흔들렸습니다 [공식 문서] (Context Rot).
4. 실험 2: 보험 회사 데이터 챗봇
실제 회사 데이터는 훨씬 복잡합니다. 테이블이 많고 코드값과 업계 용어가 가득합니다. 이번엔 앞의 2023년 연구가 공개한 보험 회사 데이터베이스(테이블 13개, 질문 44개와 정답 SQL)로 챗봇을 만들어 다시 쟀습니다 [공식 문서] (cwd-benchmark-data, Apache-2.0).
데이터 챗봇이 틀리는 곳
데이터 챗봇(Text-to-SQL)은 사람이 말로 물으면 AI가 SQL을 쓰고, 그 SQL을 실행한 결과를 보여 줍니다. 그런데 테이블만 봐서는 모르는 것이 있습니다.
- 코드값: 대리인이 판 계약을 찾으려면 역할 코드 칸을 봐야 합니다. AI는
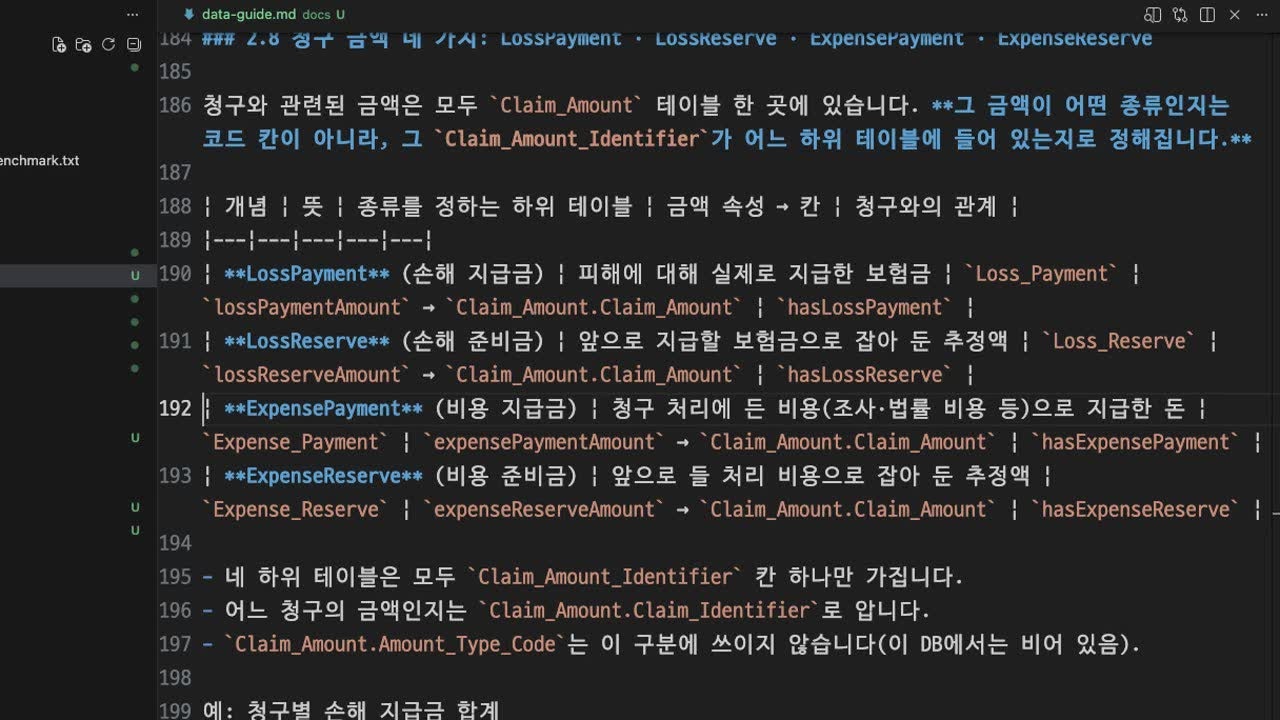
AGENT나AGT로 짐작하기 쉽지만 실제 코드는AG, 계약자는PH입니다. 데이터를 만든 회사만 아는 약속입니다. - 한 칸, 여러 뜻: 청구 금액 네 종류(손해 지급액, 손해 준비금, 비용 지급액, 비용 준비금)가
Claim_Amount테이블 하나에 섞여 있습니다. 어느 종류인지는 하위 테이블에 같은 번호가 있느냐로 갈립니다.
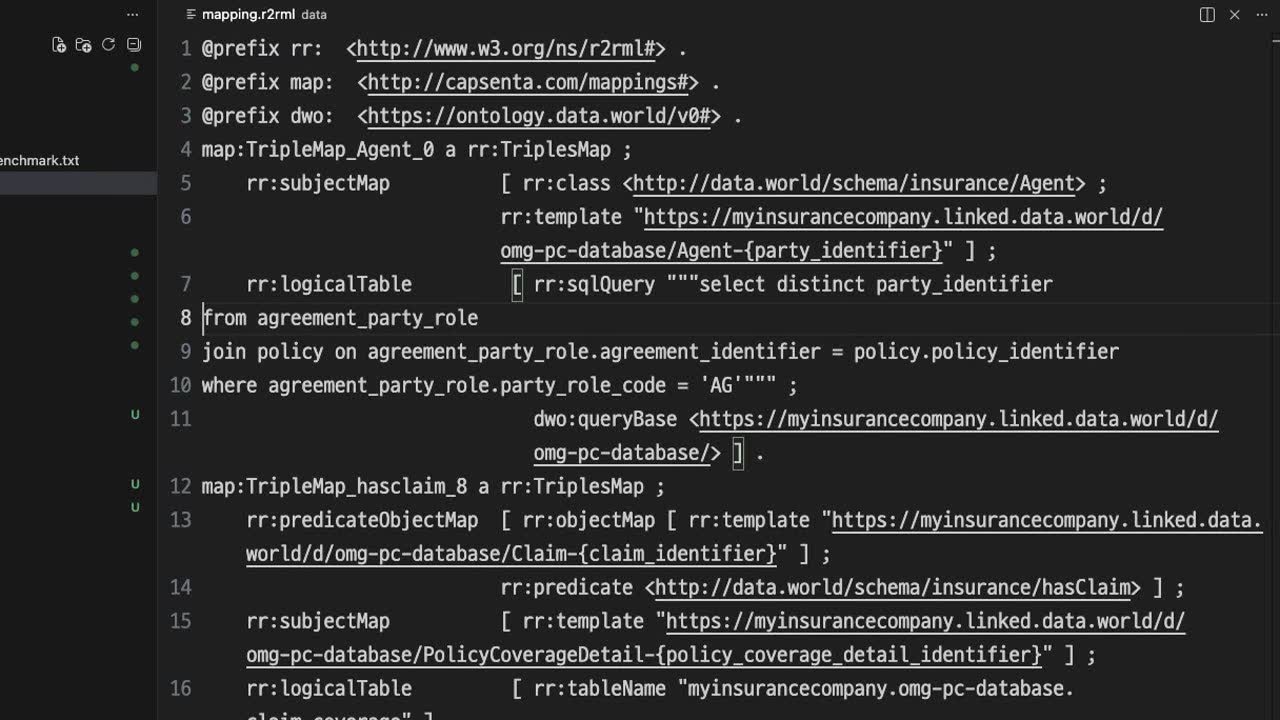
공개 데이터에는 OWL 표준 형식의 온톨로지(ontology.ttl, 클래스 11개·관계 10개)와, 그 개념이 어느 테이블·칸·조건에서 나오는지 적은 매핑 파일(mapping.r2rml)이 들어 있습니다. "대리인은 역할 코드가 AG인 줄"이라는 약속이 SQL 조각으로까지 적혀 있습니다.
방법
Claude Code로 챗봇을 처음부터 만들고, 프롬프트에 넣는 자료만 바꾼 네 가지 모드를 비교했습니다.
| 모드 | 넣는 자료 |
|---|---|
| 스키마만 | 테이블 정의(DDL) |
| +공개 온톨로지 | 스키마 + 공개 온톨로지 + 매핑 |
| +데이터 설명서 | 스키마 + Claude가 온톨로지·매핑을 사람 말로 다시 쓴 설명서 |
| +직접 만든 온톨로지 | 스키마 + 공개 온톨로지 없이 Claude가 DB만 보고 만든 온톨로지 |
"직접 만든 온톨로지"는 스탠퍼드의 안내서 「온톨로지 개발 101」의 일곱 단계를 따랐습니다 [논문] (Noy & McGuinness 2001).
- 범위를 정하고, 답해야 할 질문(역량 질문) 목록부터 적는다. 나중에 시험지가 된다.
- 이미 있는 표준을 찾는다(금융은 FIBO, 웹은 schema.org).
- 쓰는 말을 분류하지 말고 일단 다 적는다.
- 독립된 것을 클래스로 고르고 위아래로 묶는다.
- 클래스 사이의 관계를 정한다.
- 제약을 정한다(몇 개까지, 숫자인지 날짜인지).
- 실제 데이터와 잇는다(대리인 = 역할 코드 AG 같은 매핑).
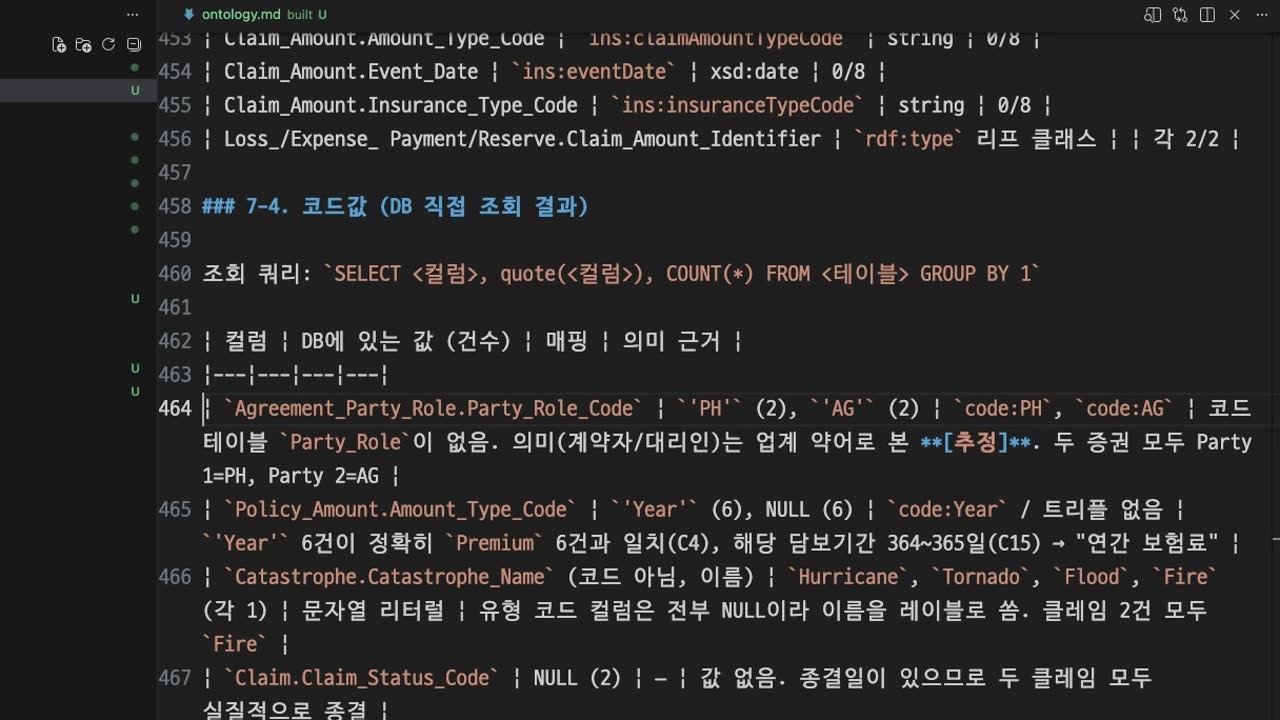
Claude는 데이터베이스를 직접 조회해 코드값이 PH, AG, Year뿐인 것을 확인했습니다. 다만 PH가 계약자, AG가 대리인이라는 뜻은 코드 정의 테이블이 없어서 [추정] 으로 표시했습니다. 데이터만으로는 알 수 없는 부분이고, 업무를 아는 사람이 확인해야 합니다. 만드는 중에 청구 하나가 다른 증권의 담보에 잘못 이어진 것 같다는 데이터 이상도 찾아냈습니다.
채점은 챗봇 SQL의 실행 결과와 정답 SQL의 실행 결과를 비교합니다. 열 이름과 행 순서는 보지 않고, 숫자는 소수 둘째 자리까지 맞춥니다. 정답은 챗봇 작업 폴더에 없었고 채점 단계에서만 들어왔습니다. 정답 SQL 44개 중 1개(평균 처리 일수)는 SQLite에서 돌도록 날짜 차이 함수만 바꿨습니다. 질문 44개 × 4모드 × 3회, 모두 528번 물었습니다.
결과
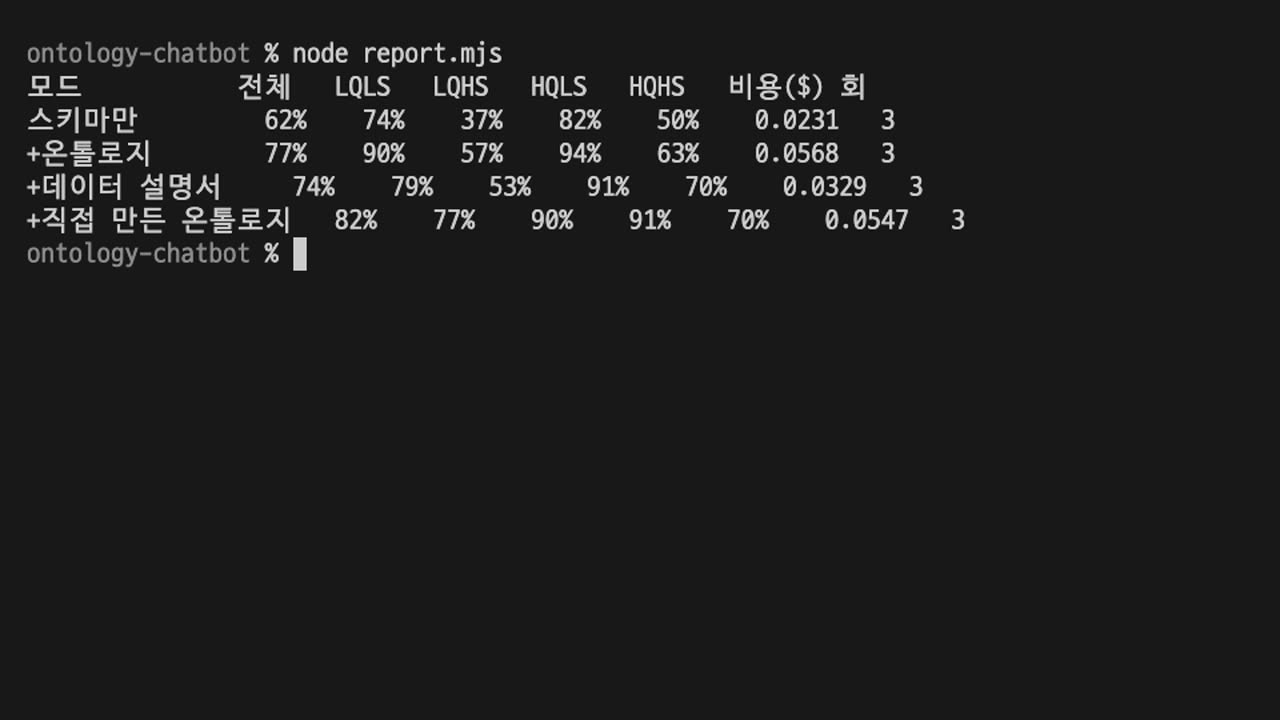
| 모드 | 전체 | LQLS | LQHS | HQLS | HQHS | 질문당 비용($) |
|---|---|---|---|---|---|---|
| 스키마만 | 62% | 74% | 37% | 82% | 50% | 0.0231 |
| +공개 온톨로지 | 77% | 90% | 57% | 94% | 63% | 0.0568 |
| +데이터 설명서 | 74% | 79% | 53% | 91% | 70% | 0.0329 |
| +직접 만든 온톨로지 | 82% | 77% | 90% | 91% | 70% | 0.0547 |
L/H는 쉬움/어려움, Q는 질문, S는 스키마입니다. LQHS면 질문은 쉬운데 스키마는 복잡한 문제입니다. [직접 측정]
- 스키마만 62% → 공개 온톨로지 77%(+15%p) → 직접 만든 온톨로지 82%. 작은 과제와 정반대 결과입니다.
- 차이가 가장 큰 곳은 질문은 쉬운데 여러 테이블을 이어야 하는 문제(LQHS) 입니다. 37%에서 직접 만든 온톨로지로 90%까지 올랐습니다. 테이블을 어떻게 이어야 하는지가 다 적혀 있으니까요.
- 데이터 설명서는 74%로 공개 온톨로지와 비슷한데, 비용은 0.0329달러로 온톨로지(약 0.055달러)의 60% 정도입니다.
왜 직접 만든 온톨로지가 이겼나
공개 온톨로지는 업계 일반 모델이라 이 DB에 없는 개념까지 들어 있습니다. 직접 만든 쪽은 DB를 조회해 실제로 들어 있는 코드값과 데이터 모양(번호가 숫자로 저장돼 있다, 보험료는 일부 줄만이다 등)을 적었고, 자기가 정한 질문을 SQL로 돌려 틀린 곳을 미리 고쳤습니다. 다만 이 DB를 보고 만든 것이라 다른 데이터에서는 다시 만들어야 합니다.
2023년 연구에서는 GPT-4가 SQL로 바로 16%였습니다. 지금 Claude는 스키마만으로도 62%입니다. 모델은 정말 좋아졌습니다. 그래도 온톨로지를 주면 77~82%까지 오릅니다. 모델이 아무리 좋아져도, AG가 대리인이라는 회사만 아는 약속은 누군가 알려 줘야 합니다.
5. 언제 쓰고, 어떻게 시작하나
온톨로지와 SDD는 경쟁 관계가 아니다
| 온톨로지 | SDD | |
|---|---|---|
| 범위 | 분야 전체 | 기능 하나 |
| 수명 | 그 일을 하는 동안 계속 | 기능이 끝나면 대부분 할 일을 다함 |
| 읽는 쪽 | 사람, 앱, 데이터, 여러 AI | 주로 구현하는 AI와 리뷰어 |
| 담는 것 | 개념, 관계, 규칙 | 요구사항, 함수, 데이터 모델, 작업 순서 |
| 관리 | 담당자를 정하고 계속 맞춤 | 기능 단위로 씀 |
SDD의 Key Entities는 그 기능이 쓰는 부분만 온톨로지에서 오려 온 것입니다. 큰 지도와, 그 지도에서 오려 낸 길 안내 같은 사이입니다.
투자할 신호 네 가지
- 테이블이 많아서 여러 번 이어야 답이 나오는 데이터
AG,PH같은 코드값과 약어가 많은 데이터- 금액 칸 하나에 네 종류가 섞인 것처럼, 같은 칸이 여러 뜻을 가진 데이터
- 여러 팀과 시스템이 같은 말을 맞춰 써야 하는 곳
프로젝트 크기별 추천
- 작은 프로젝트(저장소 하나, 기능 몇 개): 온톨로지를 따로 두지 말고 SDD의 Key Entities에 대상과 관계만 적습니다. 중요한 규칙은 테스트로 고정합니다. 실험 1이 이 경우였습니다.
- 중간 프로젝트(같은 용어·규칙이 여러 SDD에 되풀이): 용어와 규칙만 모은 가벼운 온톨로지를 한 곳에 두고, 값은 기계가 읽는 파일 하나에 둡니다.
- 큰 프로젝트·회사 데이터(여러 시스템과 AI가 같은 말을 씀): 정식 온톨로지와 매핑, 담당자, 기계 검사.
중간·큰 프로젝트 추천은 실측이 아니라 앞의 사례와 논문에서 끌어낸 것입니다.
시작하는 순서
- 데이터 설명서부터 만듭니다. 이번 결과에서 가장 싸면서 효과가 컸습니다.
- 초안은 AI에게 맡겨도 됩니다. 대신 [추정] 으로 표시된 곳은 업무를 아는 사람이 꼭 확인합니다.
- 역량 질문을 시험지로 계속 씁니다. 설명서나 온톨로지를 고칠 때마다 다시 돌려 정답률을 잽니다.
- 여러 시스템이 같은 말을 써야 할 때 정식 온톨로지와 매핑으로 올라갑니다.
그리고 어느 단계든, 꼭 지켜야 하는 규칙은 글보다 검사로 둡니다. Claude Code 공식 문서도 강조해도 자꾸 놓치는 지시는 훅(hook)으로 옮기라고 권합니다 [공식 문서] (Best practices).
이번 실험의 한계
- 모델 하나(Sonnet)로, 조건마다 3회씩 쟀습니다. 실험 1은 작은 과제 하나라서 퍼센트보다 방향을 봐 주세요.
- 실험 2는 공개 벤치마크 하나(보험 DB, 질문 44개)입니다. 2023년 연구처럼 지식 그래프 시스템을 따로 세우지 않고, 같은 SQL 챗봇에 넣는 자료만 바꿨습니다.
- "직접 만든 온톨로지"는 이 DB를 보고 만들었기 때문에 이 DB에 유리합니다.
- 기계가 읽는 파일 하나에 값을 두는 방법은 재지 않았습니다.
영상으로 보기
두 실험의 실제 실행 화면과 함께 영상으로 정리했습니다.
출처
- Gruber, A translation approach to portable ontology specifications (1993)
- Noy & McGuinness, Ontology Development 101 (2001)
- Palantir, Foundry Ontology core concepts
- W3C, SKOS Reference
- Google, Introducing the Knowledge Graph: things, not strings (2012)
- Sequeda·Allemang·Jacob, A Benchmark to Understand the Role of Knowledge Graphs on Large Language Model's Accuracy for Question Answering on Enterprise SQL Databases (2023) · 데이터 cwd-benchmark-data
- GitHub, Spec Kit
- Gloaguen 외, Evaluating AGENTS.md (2026)
- Chroma, Context Rot (2025)
- Anthropic, Claude Code Best practices
- 서울시 공공자전거, 따릉이 이용권 안내 (2026-10-28 확인)
- 실습 저장소: ontology-practice(실험 1) · ontology-chatbot(실험 2)