
쇼핑몰 검색창에 '강아지 사료'라고 쳤습니다. 그런데 '반려견이 먹을 밥'이라고 쓴 글은 안 나옵니다. 이번엔 AI에게 우리 회사 휴가 규정을 물어봅니다. 모른다고 하거나, 그럴듯하게 지어냅니다.
사람은 바로 아는 걸 컴퓨터는 왜 못 할까요? 이 두 문제를 푸는 기술이 임베딩과 RAG입니다. 내 문서를 읽고 답하는 사내 챗봇, 상품 검색과 추천, 고객센터 AI가 이 방식을 많이 씁니다.
이 글에서는 다음을 차례로 봅니다.
- 임베딩: 글을 숫자 지도로 바꾸는 방법
- 직접 재 보기: 문장 6개의 유사도, 그리고 임베딩의 약점
- RAG: 찾아서, 붙이고, 답하기
- 실제 문서 155개로 RAG를 돌려 보기
- RAG가 틀리는 순간과 고치는 방법
숫자 읽는 법. [공식 문서] 는 회사가 직접 낸 자료, [논문] 은 공개 논문, [직접 측정] 은 저희가 직접 코드를 돌려 잰 숫자입니다.
1. 임베딩: 글을 숫자 지도로
글자 검색은 왜 실패할까
보통 검색은 글자를 맞춰 봅니다. 검색어의 글자가 글에 들어 있으면 찾고, 없으면 못 찾습니다. '강아지 사료'와 '반려견이 먹을 밥'은 겹치는 글자가 하나도 없습니다. 그래서 뜻은 같아도 못 찾습니다.
그럼 글자 말고 뜻을 비교하면 됩니다. 컴퓨터가 뜻을 비교할 수 있게 문장을 숫자로 바꾸는 방법이 임베딩(embedding) 입니다. 문장을 숫자 공간 속 한 점으로 "끼워 넣는다"는 뜻입니다.
문장 하나 = 숫자 1024개
이번에 쓴 모델은 bge-m3 입니다. 문장 하나를 숫자 1024개로 바꿉니다 [공식 문서] (BAAI/bge-m3). 이렇게 숫자를 줄지어 놓은 목록을 벡터(vector) 라고 부릅니다. 벡터는 지도 위의 좌표라고 생각하면 쉽습니다.
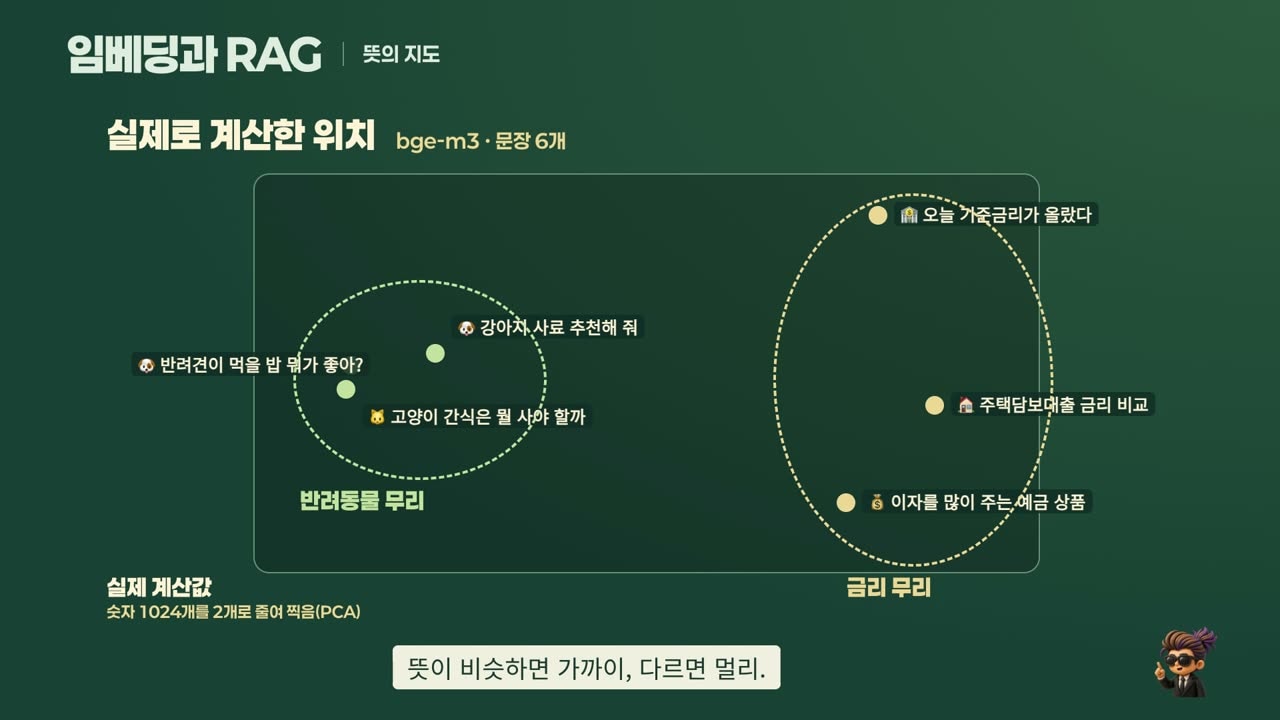
숫자 1024개는 그릴 수 없으니 두 개로 줄여서(PCA) 지도에 찍었습니다. 실제로 계산한 위치입니다. 반려동물 문장 셋은 왼쪽에, 금리 문장 셋은 오른쪽에 모였습니다. [직접 측정] 뜻이 비슷하면 가까이, 다르면 멀리. 임베딩이 하는 일은 이게 전부입니다.
가까운 정도는 각도로 잰다
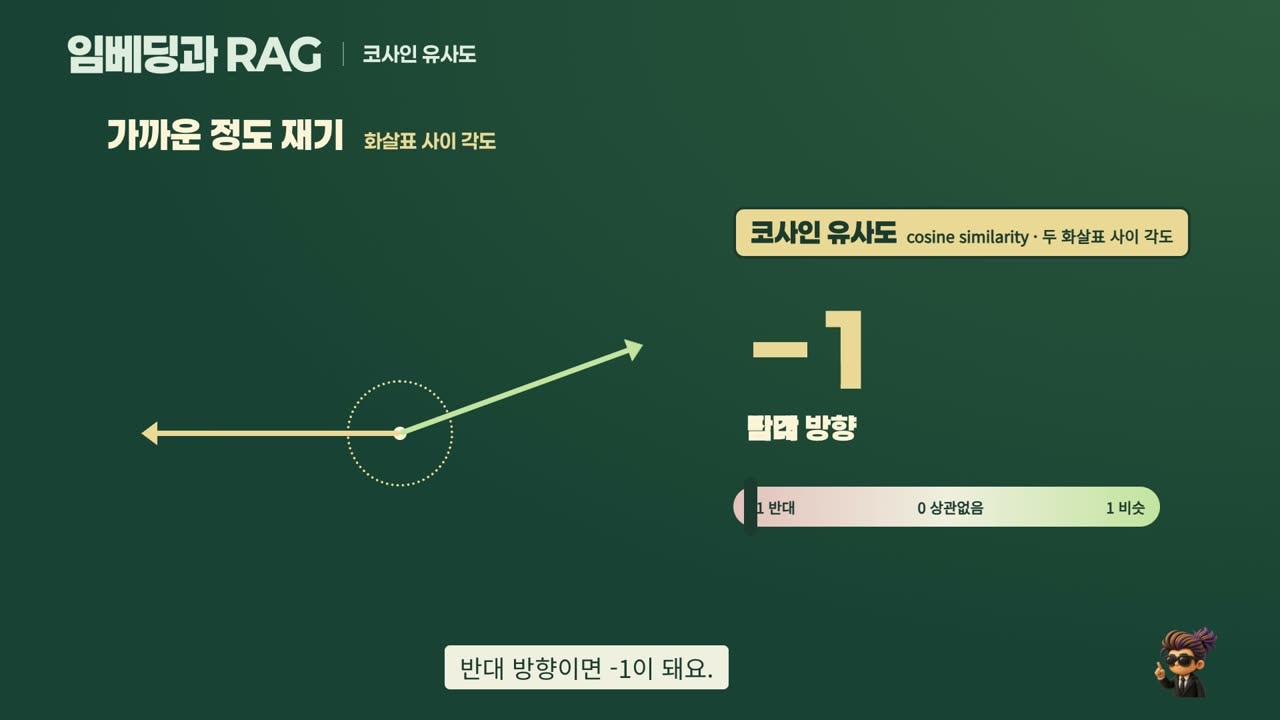
가까운 정도는 두 화살표 사이의 각도로 잽니다. 이것을 코사인 유사도(cosine similarity) 라고 합니다. 같은 방향이면 1, 직각이면 0, 반대 방향이면 -1입니다. 1에 가까울수록 뜻이 비슷한 문장입니다.
모델은 뜻을 어떻게 배웠을까
아주 많은 문장 짝으로 연습합니다. 질문과 그 질문의 답처럼 짝이 맞는 문장은 가까이 당기고, 짝이 아닌 문장은 멀리 밉니다. 이걸 수없이 반복하면 뜻이 같은 문장끼리 모이는 지도가 만들어집니다. 이 방법을 대조 학습(contrastive learning) 이라고 합니다.
2. 직접 재 보기
문장 6개의 유사도
공개 실습 저장소의 a3/heatmap.py는 세 부분으로 되어 있습니다.
- 문장 파일을 읽어 한 줄에 한 문장씩 목록을 만듭니다.
- 임베딩 모델로 문장마다 숫자 1024개로 바꿉니다. 이때 화살표 길이를 1로 맞추는 옵션(정규화)을 켭니다.
- 숫자 목록끼리 곱합니다. 길이가 1이니 곱한 값이 바로 코사인 유사도입니다. 모든 짝을 한 번에 곱해 표를 만듭니다.
'강아지 사료 추천해 줘'와 나머지의 점수는 이랬습니다. [직접 측정]
| 비교한 문장 | 점수 |
|---|---|
| 반려견이 먹을 밥 뭐가 좋아? | 0.73 |
| 고양이 간식은 뭘 사야 할까 | 0.69 |
| 금리 문장 3개 | 0.40 ~ 0.46 |
겹치는 글자가 하나도 없는 '반려견이 먹을 밥'이 가장 가깝다고 나왔습니다. 글자 검색이 못 찾은 글을 이제 찾을 수 있습니다.
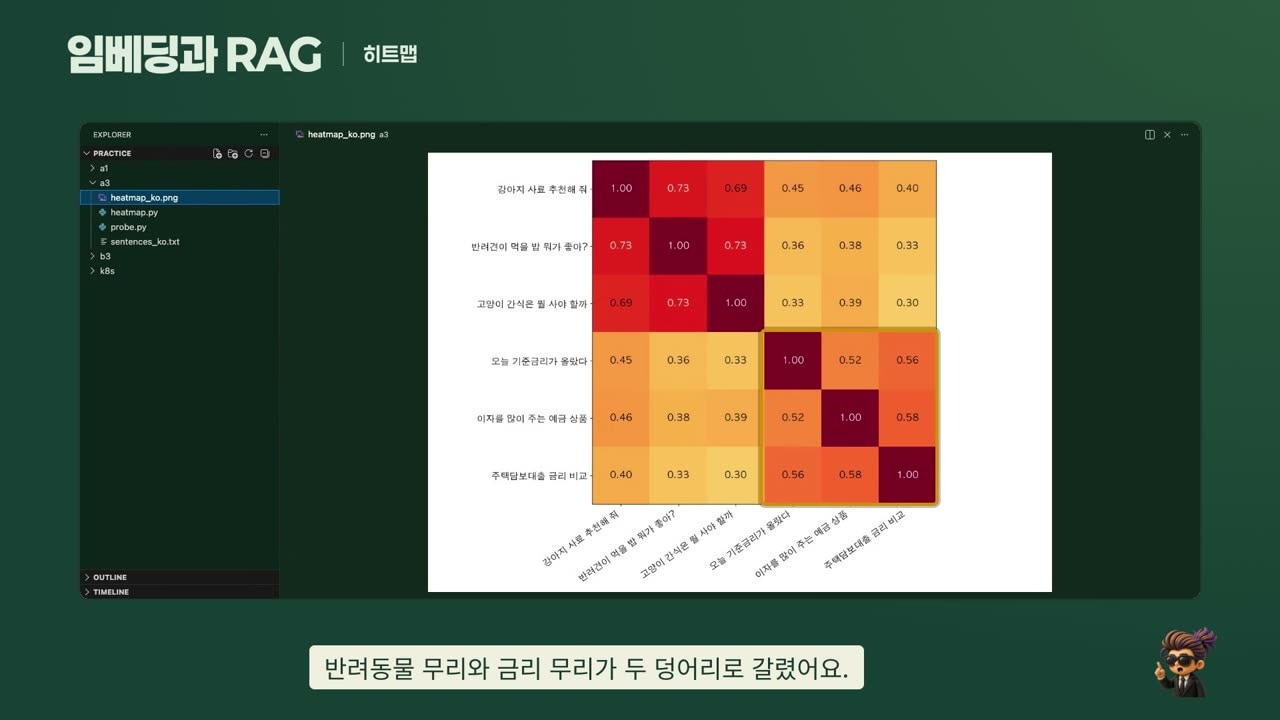
표의 숫자를 색의 진하기로 보여 주는 그림을 히트맵(heatmap) 이라고 합니다. 색이 짙을수록 비슷한 문장입니다. 반려동물 무리와 금리 무리가 두 덩어리로 갈렸습니다.
임베딩의 약점
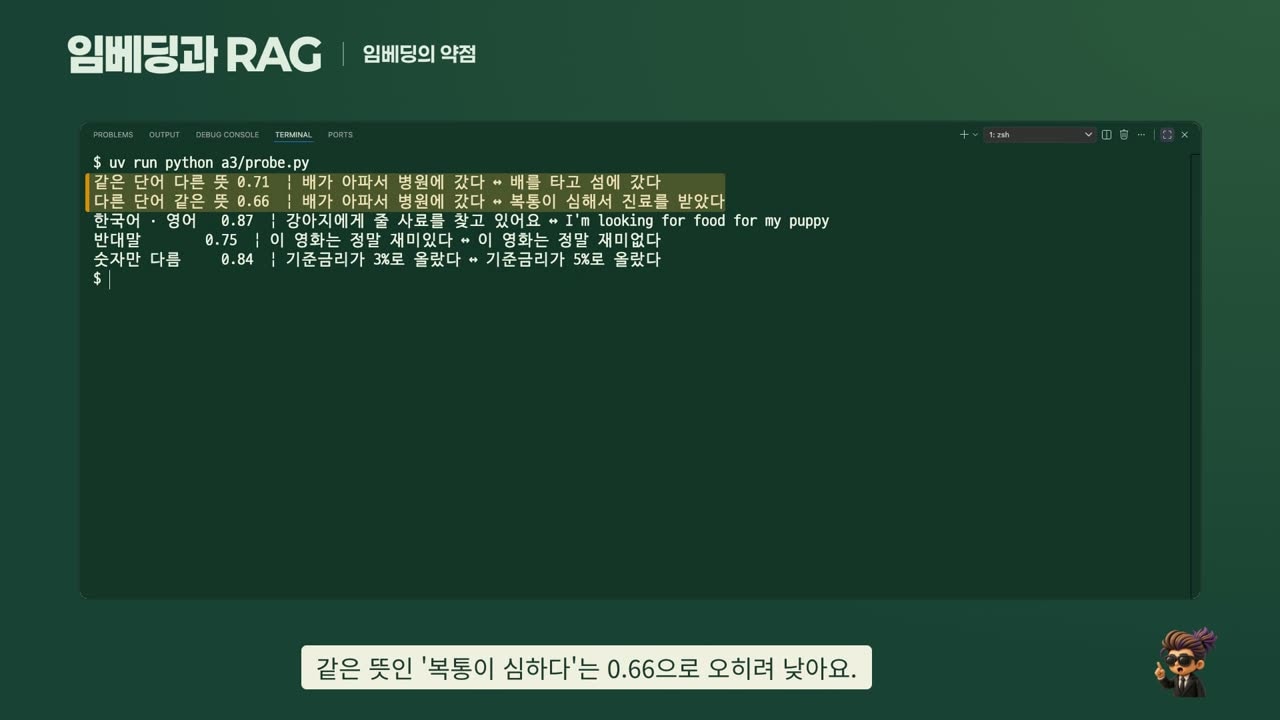
그럼 임베딩은 늘 믿을 만할까요? 헷갈리기 쉬운 문장 짝 다섯 개를 a3/probe.py로 재 봤습니다. [직접 측정]
| 문장 짝 | 관계 | 점수 |
|---|---|---|
| 배가 아파서 병원에 갔다 ↔ 배를 타고 섬에 갔다 | 같은 단어, 다른 뜻 | 0.71 |
| 배가 아파서 병원에 갔다 ↔ 복통이 심해서 진료를 받았다 | 다른 단어, 같은 뜻 | 0.66 |
| 이 영화는 정말 재미있다 ↔ 이 영화는 정말 재미없다 | 반대말 | 0.75 |
| 기준금리가 3%로 올랐다 ↔ 기준금리가 5%로 올랐다 | 숫자만 다름 | 0.84 |
| 강아지에게 줄 사료를 찾고 있어요 ↔ I'm looking for food for my puppy | 한국어·영어, 같은 뜻 | 0.87 |
뜻이 전혀 다른 '배를 탄다'가, 같은 뜻인 '복통이 심하다'보다 높습니다. 같은 글자 '배'에 끌린 것입니다. 문장 모양이 비슷하면 가깝게 봐서 반대말과 숫자를 잘 못 가립니다. 대신 언어가 달라도 뜻이 같으면 한 지도에 모입니다.
그래서 현업에서는 임베딩만 믿지 않습니다. 정확한 이름이나 숫자는 글자를 맞춰 보는 검색과 섞어서 보완합니다. 이렇게 섞는 것을 하이브리드 검색(hybrid search) 이라고 합니다. 애플 뮤직 검색 팀은 기존 글자 검색에 임베딩 검색을 더해서, 검색 결과가 하나도 안 나오는 경우를 86% 줄였다고 발표했습니다 [논문] (Multilingual Semantic Retrieval for Apple Music Search, arXiv 2607.10239).
3. RAG: 찾아서, 붙이고, 답하기
AI는 내 문서를 모른다
AI에게 "애플 뮤직 검색 팀이 2026년 논문에서 빈 결과를 얼마나 줄였나"를 물었습니다(a1/ask.py).
- 문서 없이 질문만 보내면: 그 논문의 수치는 확인할 수 없다고 답했습니다.
- 논문 내용을 적은 문서 한 줄을 같이 보내면: 86%라고 정확히 답했습니다. [직접 측정]
모델이 똑똑해진 게 아니라, 답이 든 글을 같이 줬기 때문입니다.
챗GPT나 클로드 같은 AI를 LLM(Large Language Model, 큰 언어 모델) 이라고 부릅니다. LLM은 정해진 날짜까지 모은 글로 공부를 끝낸 모델입니다. 그래서 그 뒤에 생긴 일과 공개된 적 없는 내 문서는 모릅니다. 모르는 걸 물으면 모른다고 하거나 그럴듯하게 지어내는데, 이렇게 지어낸 답을 환각(hallucination) 이라고 합니다.
문서를 전부 붙이면 안 될까
몇 장이면 괜찮지만, 수천 개면 한 번에 넣을 수 없습니다. 넣을 수 있는 양에 한도가 있고, 많이 넣을수록 비용도 늘어납니다. 그래서 질문에 맞는 부분만 골라서 붙입니다. 찾아서, 붙이고, 답하게 하는 방식. 이것이 RAG(Retrieval-Augmented Generation, 검색 증강 생성) 입니다. 2020년 논문에서 나온 이름입니다 [논문] (Lewis et al. 2020).
오픈북 시험을 떠올리면 쉽습니다. 외운 것만으로 푸는 시험에서는 모르는 문제가 나오면 비워 두거나 지어냅니다. 책을 펴 놓고 보는 시험이라면 맞는 쪽을 찾아서 보고 쓸 수 있습니다. RAG는 AI가 책을 들고 시험장에 들어가게 해 주고, 답 옆에 몇 쪽을 보고 썼는지 적게 해서 사람이 확인할 수 있게 합니다.
내 문서를 모델에게 다시 공부시키는 파인튜닝(fine-tuning, 미세 조정) 도 있습니다. 하지만 문서가 바뀔 때마다 다시 공부시켜야 해서, 자주 바뀌는 문서에는 보통 RAG를 먼저 씁니다.
RAG는 이렇게 움직인다
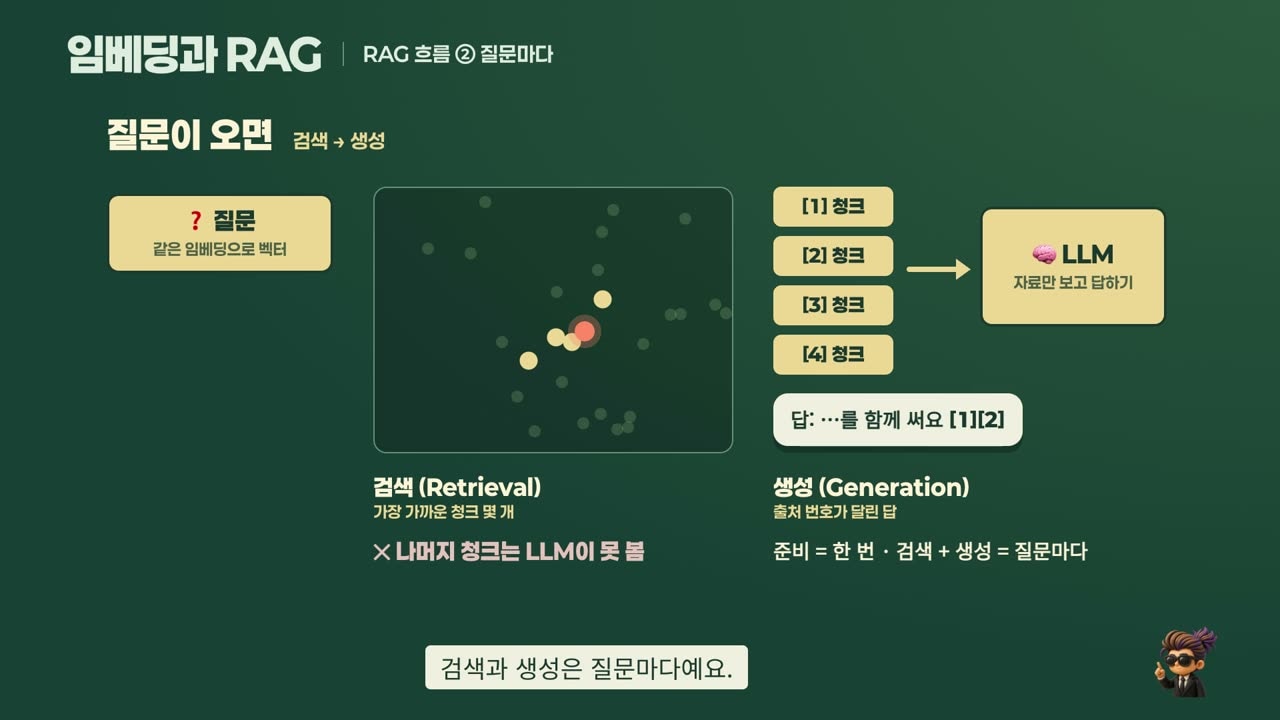
크게 두 부분입니다.
- 준비(한 번): 문서를 불러와 작은 조각으로 자르고, 조각마다 임베딩으로 벡터를 만들어 저장합니다. 이 조각을 청크(chunk), 자르는 일을 청킹(chunking) 이라고 합니다. 벡터를 저장해 두고 가까운 것을 빨리 찾아 주는 저장소는 벡터 데이터베이스입니다.
- 질문마다: 질문도 같은 임베딩으로 벡터로 바꾸고, 가장 가까운 청크 몇 개를 꺼냅니다(검색). 꺼낸 청크에 번호를 붙여 질문과 함께 LLM에게 보내고, "아래 자료만 보고 답하고 근거 번호를 달라"고 합니다. LLM이 출처 번호가 달린 답을 씁니다(생성).
왜 자를까요? 두꺼운 책을 통째로 들고 다니는 대신 메모 카드에 나눠 적는 것과 같습니다. 문서 전체를 벡터 하나로 만들면 여러 이야기가 섞여 흐려지고, 카드로 나누면 질문에 맞는 카드만 골라 붙일 수 있습니다. 정리하면, RAG는 임베딩 검색에 마지막 생성 한 단계를 더한 것입니다.
4. 실제 문서로 돌려 보기
자료는 쿠버네티스 공식 문서 한국어판의 개념 설명 문서입니다. 쿠버네티스는 서버 프로그램을 운영하는 도구입니다.
- 문서 155개, 1,103,975자(약 110만 자)
- 500자씩 잘라 청크 3,033개
- 임베딩 bge-m3, 질문마다 상위 4개 청크를 붙임 [직접 측정]
b3/rag.py는 40줄이 안 됩니다. 세 부분입니다.
- 검색: 질문을 벡터로 바꾸고, 미리 만든 청크 3,033개와 한꺼번에 곱해서 점수가 높은 4개를 꺼냅니다.
- 붙이기: 꺼낸 청크 4개에 1번부터 번호와 문서 제목을 달아 한 글로 이어 붙입니다.
- 생성: "아래 자료만 보고 답하고, 문장 끝에 근거 번호를 붙이고, 자료에 없으면 모른다고 하라"는 지시와 함께 LLM에게 보냅니다.
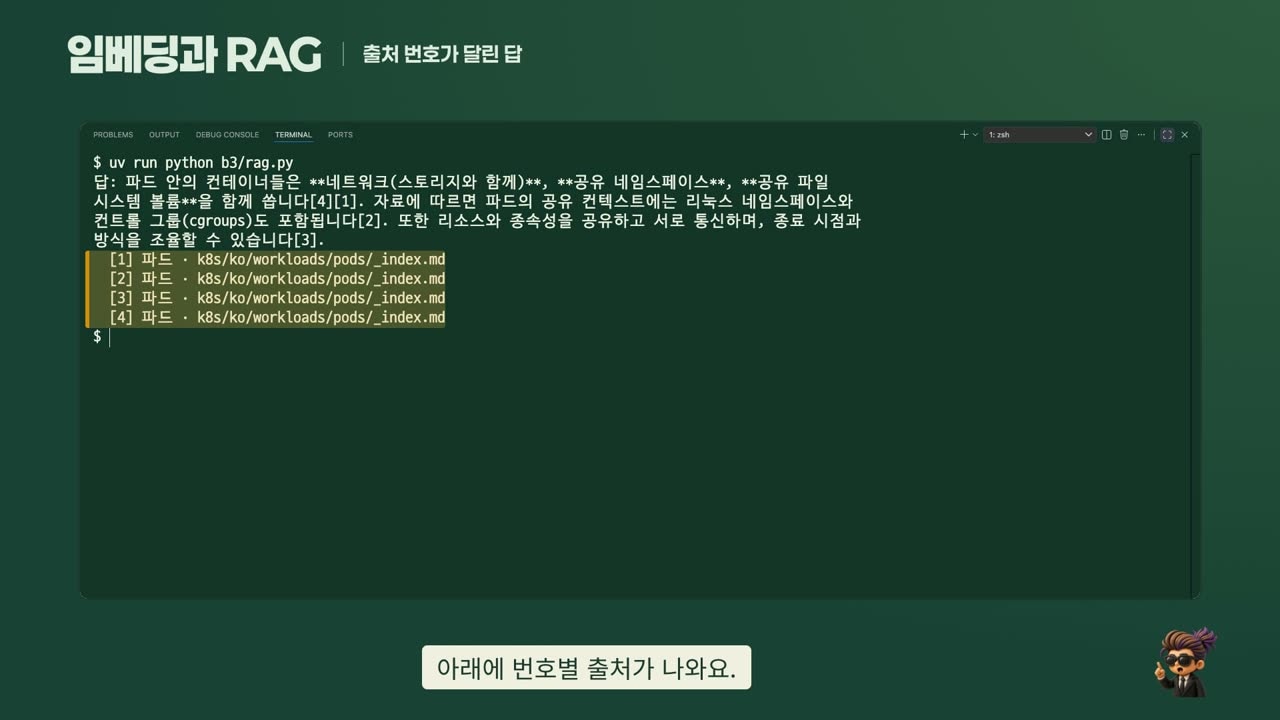
첫 질문은 "파드 안의 컨테이너들은 무엇을 함께 쓰나요?"입니다. 파드는 쿠버네티스에서 프로그램을 묶어 돌리는 단위입니다. 답은 "네트워크와 공유 네임스페이스, 파일 시스템 볼륨을 함께 쓴다"였고, 문장마다 대괄호 번호가 달렸습니다. 출처 4개는 모두 파드 문서였습니다. [직접 측정]
5. RAG가 틀리는 순간
두 번째 질문은 "디플로이먼트를 이전 버전으로 되돌리려면 어떻게 하나요?"입니다. 디플로이먼트는 프로그램을 새 버전으로 바꿔 주는 기능입니다.
RAG는 "자료에 구체적인 명령어나 절차는 나와 있지 않습니다" 라고 답했습니다. 그런데 디플로이먼트 문서에는 되돌리는 명령이 그대로 나와 있습니다. 모른다고 하라는 지시는 잘 지켰지만, 문서에 답이 있었으니 사용자에겐 틀린 답입니다.
넘긴 청크를 들여다보면
b3/peek.py로 정답 명령이 든 청크가 몇 위였는지 찍었습니다. [직접 측정]
- 넘긴 4개는 모두 디플로이먼트 문서에서 왔습니다. 문서는 제대로 찾았습니다.
- 그런데 되돌리는 방법이 적힌 청크는 그 안에 없었습니다.
- 정답 청크는 12위, 점수 0.642. 4위는 0.661입니다. 0.02도 안 되는 차이로 밀렸습니다.
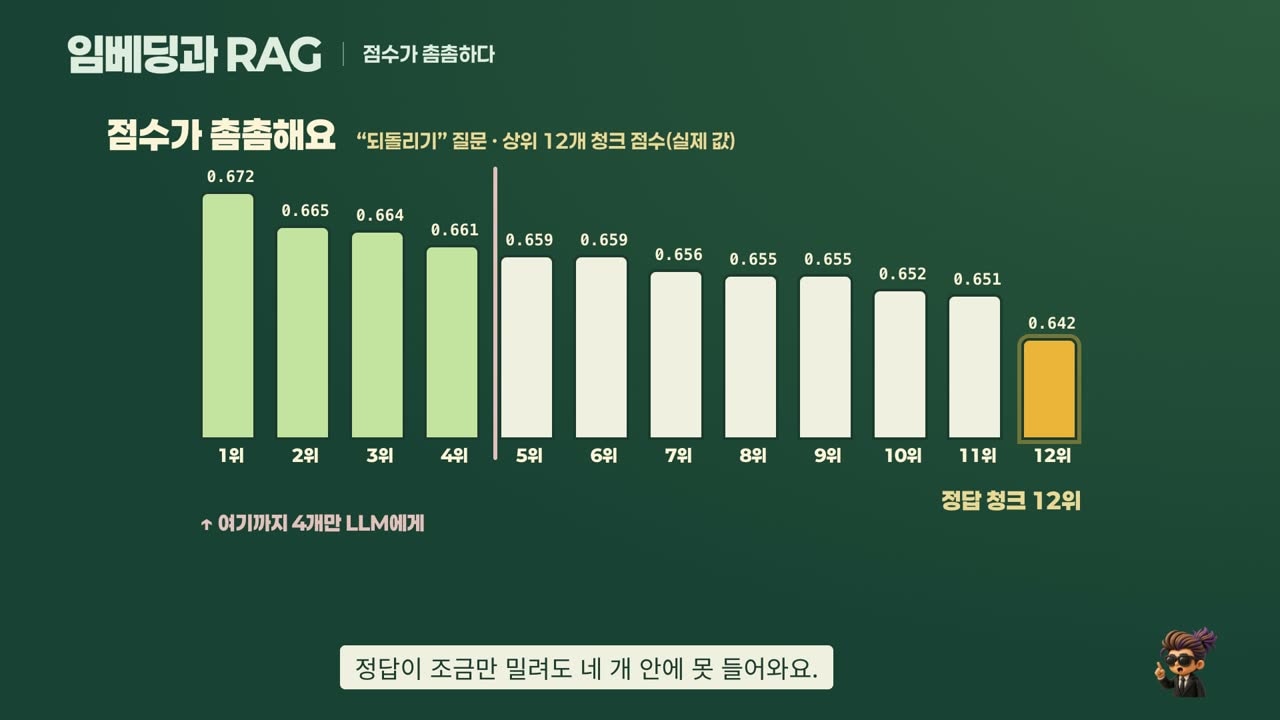
디플로이먼트 문서 하나가 여러 청크로 나뉘어 있고, 질문은 그 청크들과 모두 비슷합니다. 1위 0.672부터 12위 0.642까지 점수가 촘촘하게 붙어 있어서, 정답이 조금만 밀려도 4개 안에 못 들어옵니다.
그래서 RAG의 품질은 검색이 절반입니다. LLM이 아무리 좋아도 받은 청크 밖의 내용은 모릅니다. 답이 틀리면 LLM보다 먼저 검색된 청크를 들여다봐야 합니다.
고치는 방법
- 하이브리드 검색: 뜻 검색과 글자 검색을 섞습니다.
- 리랭킹(reranking): 후보를 넉넉히 찾은 뒤, 더 꼼꼼한 모델로 다시 순위를 매깁니다.
- 청킹 바꾸기: 자르는 크기나 경계를 바꿉니다.
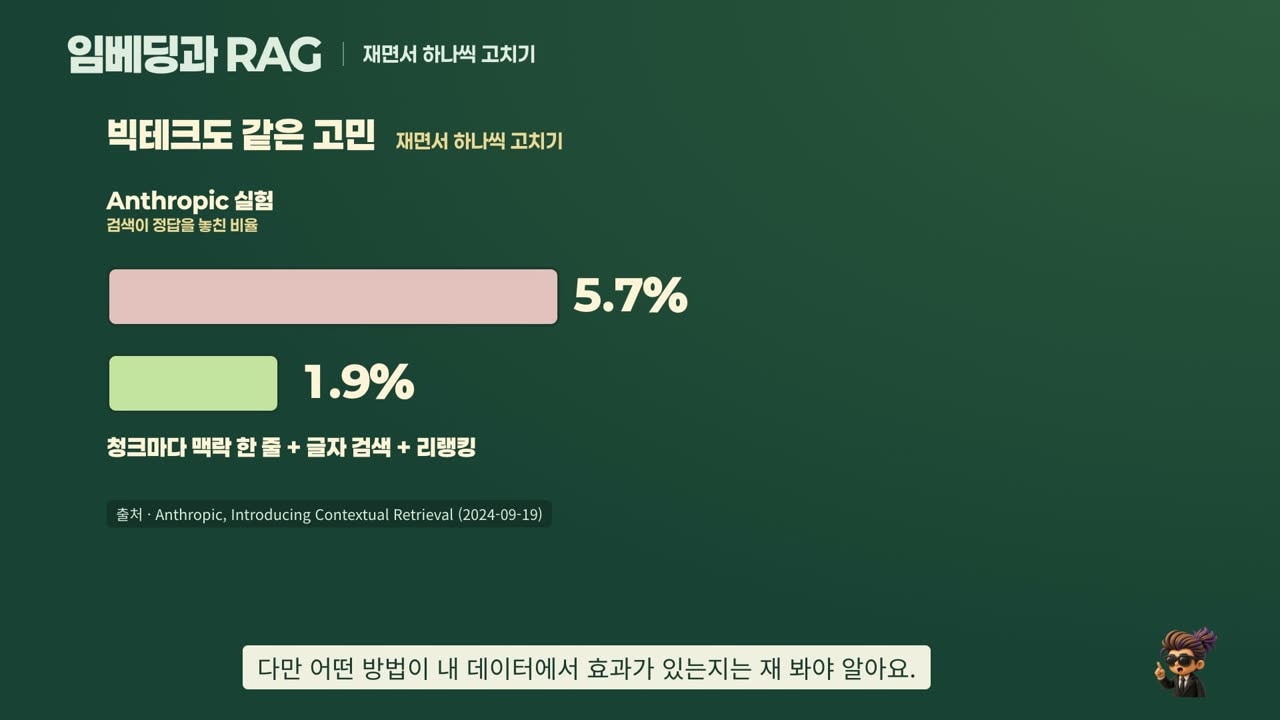
빅테크도 같은 고민을 합니다. Anthropic은 청크마다 문서 맥락을 한 줄 붙이고, 글자 검색(BM25)과 리랭킹까지 더해서, 상위 20개 청크 안에 정답이 없는 비율을 5.7%에서 1.9%로(67% 감소) 줄였다고 공개했습니다 [공식 문서] (Introducing Contextual Retrieval).
다만 어떤 방법이 내 데이터에서 효과가 있는지는 재 봐야 압니다. 그래서 현업에서는 정답을 아는 질문 묶음을 만들어 두고, 점수를 재면서 하나씩 고칩니다.
정리
- 임베딩은 문장을 뜻의 지도 위 점(벡터)으로 바꿉니다. 글자가 달라도 뜻이 같으면 가깝습니다. 다만 반대말과 숫자는 잘 못 가립니다.
- 코사인 유사도는 두 화살표 사이 각도로 잰 가까운 정도입니다.
- RAG는 질문에 맞는 청크를 임베딩으로 찾아, 질문과 함께 LLM에게 붙여 주고, 출처 번호를 단 답을 쓰게 하는 방식입니다.
- RAG가 틀리면 LLM보다 먼저 검색을 보세요. 정답 청크가 몇 위였는지 확인하는 것부터가 시작입니다.
이번 실험의 한계
- 임베딩 모델 하나(bge-m3), 답하는 LLM 하나, 문서 묶음 하나(쿠버네티스 한국어 개념 문서)로만 돌렸습니다.
- 유사도 점수는 문장 몇 개와 질문 두 개로 본 예시입니다. 모델이나 문장이 바뀌면 숫자도 달라집니다.
- 하이브리드 검색·리랭킹·청킹 변경은 방법만 소개했고, 이 문서 묶음에서 직접 고쳐 보지는 않았습니다. 그래서 "12위가 몇 위로 올라온다"는 숫자는 이 글에 없습니다.
영상으로 보기
같은 내용을 그림과 실제 실행 화면으로 한국어 영상에 담았습니다.
출처
- Apple Music 검색 팀, Multilingual Semantic Retrieval for Apple Music Search (arXiv 2607.10239, 2026)
- Anthropic, Introducing Contextual Retrieval (2024-09-19)
- Lewis et al., Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks (2020)
- BAAI, bge-m3 모델 카드 · Chen et al., BGE M3-Embedding (2024)
- 쿠버네티스 공식 문서 한국어판, 개념 (kubernetes/website, CC BY 4.0)
- 실습 코드: dante01yoon/embedding-rag-practice (
a1/ask.py,a3/heatmap.py,a3/probe.py,b3/rag.py,b3/peek.py)