
기획서 하나를 주고 4시간 반을 기다렸더니, 음성 비서가 완성돼 있었다고 합니다. 구글의 새 모델 제미나이 4 카본(Gemini 4 Carbon) 이 혼자 만든 결과라고 해요.
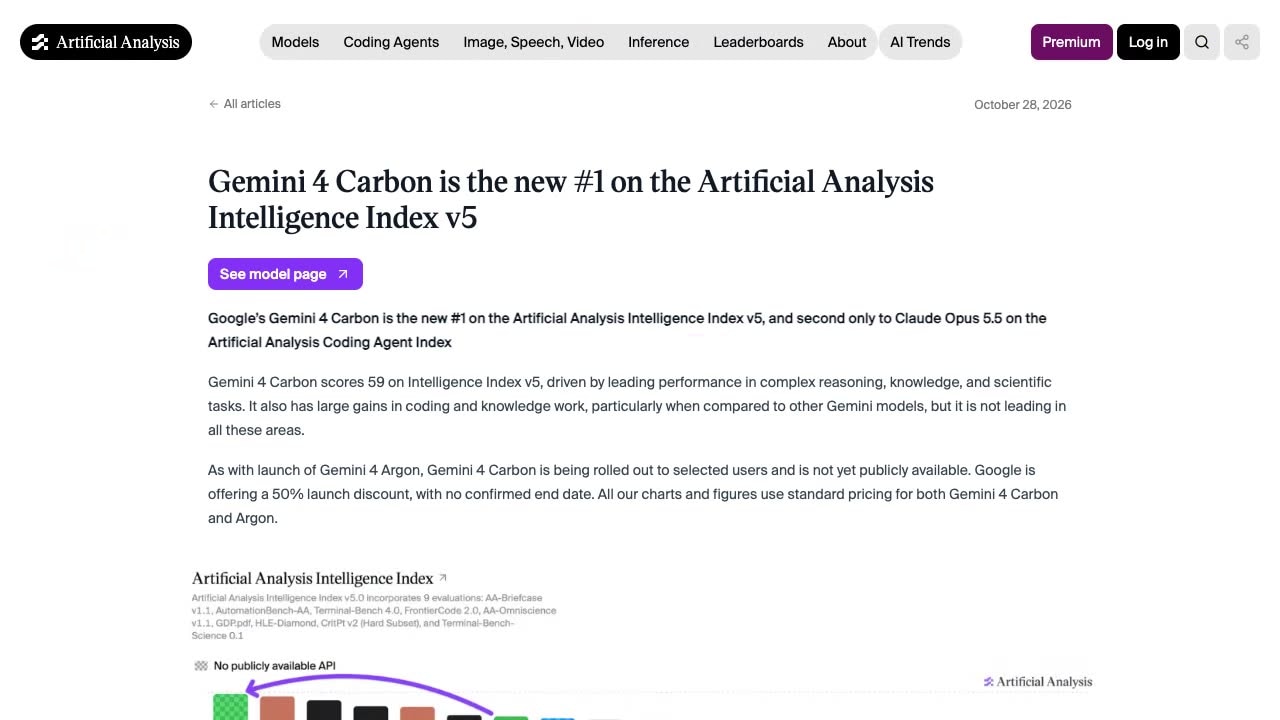
카본은 10월 28일 발표 날 독립 측정 사이트 Artificial Analysis의 종합 지수에서 1위였습니다. 토큰 단가는 Claude Fable 5.2의 절반이고, 11월 한정 출시 가격으로는 4분의 1입니다. 그런데 2주 뒤 리더보드에서는 네 번째 줄로 내려와 있었습니다.
그렇다면 질문은 하나입니다. 단가가 반값이면, 일 하나를 끝내는 값도 반값일까요?
이 글에서는 다음을 차례로 봅니다.
- 카본은 어떤 모델인가
- 먼저 써 본 사람들의 결과
- 아르곤과 무엇이 다른가
- 경쟁 모델과 견주기
- 진짜 값: 과제당 비용
- 약점: 속도
- 어느 요금제부터 쓸 수 있나
- 고르는 기준과 한계
숫자 읽는 법. [공식 문서] 는 구글이 직접 낸 자료(블로그, 모델 카드, 안전 보고서, 가격표), [커뮤니티 보고] 는 구글이 아닌 곳(독립 측정 사이트, 개발자 채널·블로그)이 공개한 결과로 저희가 재현하지 않은 것, [직접 측정] 은 저희 계정 화면에서 직접 확인한 값입니다. 숫자는 모두 2026년 11월 11일 기준이고, 리더보드는 계속 바뀝니다.
1. 카본은 어떤 모델인가
카본은 제미나이 4 가운데 가장 위에 있는 모델입니다 [공식 문서].
- 10월 28일 발표, 처음 2주는 보안 방어자와 파트너(Fairwind 프로그램)에게만 열렸고, 11월 10일 일반 공개됐습니다 [공식 문서].
- 구글은 카본을 두 가지에 맞췄다고 설명합니다. 하나는 보안, 다른 하나는 롱 호라이즌(long-horizon) 입니다. 롱 호라이즌은 사람 없이 몇 시간, 며칠씩 이어 가는 긴 작업을 말합니다 [공식 문서].
- 아르곤보다 토큰을 더 써서 깊게 탐색하고 검증을 되풀이한다고 합니다. 구글 스스로도 대부분의 개발·지식 업무에는 아래 모델 아르곤이 맞다고 썼습니다 [공식 문서].
구글은 펠리컨이 자전거를 타는 3D 게임, 시의회 계획 PDF로 만든 사옥 3D 모델 같은 결과물을 공개했습니다. 이런 결과물은 스웜(swarm) 이라는 기능으로 만들었다고 합니다. 요청 하나를 에이전트 여럿이 나눠 맡는 방식입니다 [공식 문서]. 다만 이건 구글이 골라서 보여 준 장면입니다. 그래서 다른 사람들이 돌린 결과를 이어서 봅니다.
2. 먼저 써 본 사람들의 결과
아래는 모두 각 채널·블로그가 직접 돌려 밝힌 결과입니다. [커뮤니티 보고]
codeSTACKr: 기획서 하나로 4시간 반
- 음성 서비스 회사 LiveKit 쪽이 미리 써 본 결과입니다. 무엇을 만들지 적은 기획서(PRD, 제품 요구 문서) 하나만 주고 끝날 때까지 손대지 않았다고 합니다.
- 4시간 반쯤 뒤, 말로 문서를 열고 가격 PDF를 찾고 양식을 채우는 음성 비서가 나왔습니다. 그동안 카본은 한 번도 되묻지 않았다고 합니다.
- 제출 전에 꼭 사람 확인을 받도록 코드로 막고, 그 테스트도 짰다고 합니다.
- 화면 클릭이 빗나가는 문제는 기획서에 일부러 안 적었는데, 카본이 오차를 재고 스크린샷 크기를 스스로 바꿔 고쳤다고 합니다.
같은 채널은 실제 버그 두 개를 카본, 아르곤, Opus 5.5에 증상만 알려 주고 고치게 했습니다.
| 과제 | 결과 |
|---|---|
| 버그 1 | 셋 다 같은 한 줄 수정을 찾음. 카본 68분, Opus 5.5 15분 |
| 버그 2 | 셋 다 완전히 풀지 못함 |
| 보안 리뷰 | 가장 심각한 프레임워크 버그를 카본만 찾음. 다만 찾은 문제 대부분의 심각도를 실제보다 높게 매김 |
Sam Witteveen: 3D 건물과 맥 앱
- 싱가포르 마리나 베이 샌즈를 3D로 만들어 달라고 했습니다. 에펠탑보다 인터넷 자료가 적을 건물을 일부러 골랐는데, 거의 한 번에 나왔고 구름·사람을 넣는 프롬프트를 두세 번 더 썼다고 합니다.
- 「최고의 뽀모도로 맥 앱을 만들어 줘」로 시작하는 짧은 프롬프트로는 Swift 맥 전용 앱을 만들었습니다. 뽀모도로는 집중 시간을 재는 타이머입니다. 요청하지 않은 메뉴 막대 기능까지 들어 있었고, 컴파일된 앱 파일을 받아 바로 실행했다고 합니다.
- 이 채널은 카본을 "걸어 두고 자리를 뜨는" 모델이라고 했고, 대화용으로는 쓰지 않겠다고 했습니다.
Paul J Lipsky: 같은 프롬프트로 아르곤과 나란히
- 우주 비행 게임을 두 모델에 똑같이 시켰습니다. 카본 쪽이 훨씬 깔끔하고, 아르곤 쪽은 화면이 더 붐비고 기체가 각져 보이며 조작도 덜 먹는다고 평가했습니다.
- 코드만으로 그림을 그리게 했을 때, 노인 초상은 카본이 더 세밀했지만 본인 사진을 다시 그리게 하자 아르곤 결과가 훨씬 좋아 보였다고 합니다. 이유를 묻자 카본은 "아르곤은 원본 사진을 숫자 목록으로 바꿔 코드에 넣었고, 카본은 수식으로만 그렸다"고 답했다고 합니다. 카본이 내놓은 설명일 뿐, 코드를 확인했다는 말은 영상에 없습니다.
- 영상 편집을 맡겼을 때는 Opus 5.5보다 훨씬 오래 걸렸지만 한 번에 끝냈다고 합니다.
Bijan Bowen, Simon Willison
- Bijan Bowen은 브라우저 안에 운영체제를 통째로 만들게 했고, 그 안의 자동차 게임을 두고 아르곤보다 훨씬 낫다고 했습니다. 다만 아르곤 결과는 화면에 없고 기억으로 견준 말입니다. "Claude 수준에 완전히 닿지는 못했지만, Claude가 아닌 모델 가운데선 가장 가깝다"고 평가했습니다.
- 개발자 Simon Willison은 자전거 타는 펠리컨 그림과 로봇 애니메이션을 블로그에 올렸습니다. 로봇은 하루 전 Fable 5.2에 쓴 프롬프트 그대로이고, 후속 지시는 한 번이었다고 합니다.
묶어 보면, 오래 맡겨 두는 긴 작업에서는 평가가 좋았고, 대화나 빠른 수정에는 다른 모델을 쓰겠다는 말이 두 채널에서 나왔습니다.
3. 아르곤과 무엇이 다른가
지난달 나온 제미나이 4 아르곤과는 API 단가가 똑같습니다. 12월 1일에 같이 두 배로 오르는 것도 같습니다 [공식 문서].
| 항목 | 아르곤 | 카본 | 구분 |
|---|---|---|---|
| 모델 카드 17개 시험 | 17개 모두 낮음 | 17개 모두 높음 | [공식 문서] |
| ExploitGym (보안) | 42.0% | 54.8% | [공식 문서] |
| 문제를 숨기지 않고 보고한 비율 | 70% | 92% | [공식 문서] |
| ARC-AGI-3 (처음 보는 퍼즐 추론) | 49.8% | 65.1% | [커뮤니티 보고] ARC Prize |
| Arena 텍스트 (사람 투표) | 1522 | 1526 (잠정) | [커뮤니티 보고] Arena |
| 출력 토큰 | 기준 | 약 1.8배 | [커뮤니티 보고] Artificial Analysis |
| 첫 답까지 걸린 시간 | 39초 | 66초 | [커뮤니티 보고] Artificial Analysis |
| 환각 비율 (모르는 걸 지어냄) | 4% | 11% | [커뮤니티 보고] Artificial Analysis |
Arena의 4점 차는 오차 범위 안이고, 카본 쪽 점수에는 아직 확정 전이라는 잠정 표시가 붙어 있습니다. 성능이 오른 만큼 토큰과 시간을 더 쓰고, 환각도 늘었습니다. 그렇다고 과제당 비용이 꼭 더 비싼 건 아닙니다. Vals AI 측정에서는 카본이 오히려 낮았습니다(5절).
구글의 94쪽짜리 안전 보고서에도 아르곤이 나옵니다. 구글은 카본이 아르곤보다 의미 있는 새 능력을 보이지 않아서 아르곤 때의 능력 평가와 판정을 이어받았다고 적었습니다. 동시에 모델 바깥 안전장치가 없으면 사이버·생물 정보 기준에 닿을 가능성을 배제할 수 없어서, 사이버 악용 방어를 아르곤보다 강화했다고 밝혔습니다 [공식 문서].
4. 경쟁 모델과 견주기
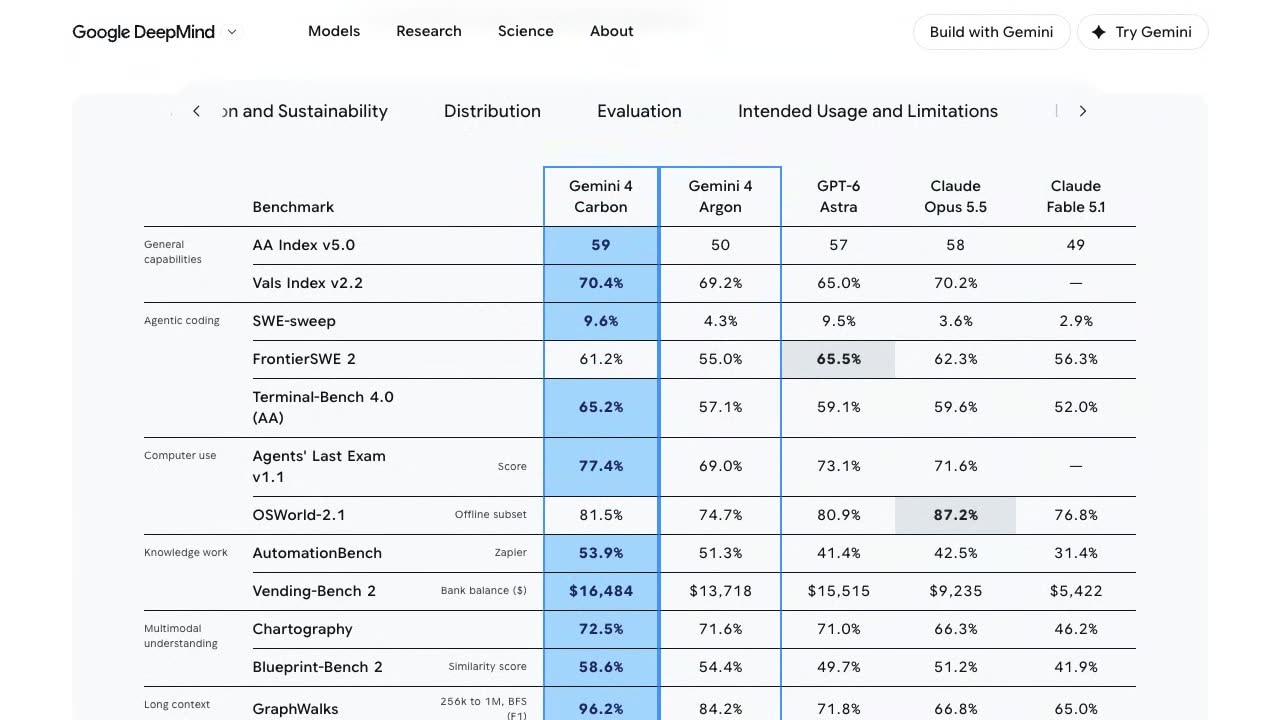
구글 모델 카드 표에서 카본은 긴 문맥 시험 96.2%, 업무 자동화 시험(AutomationBench) 53.9% 로 가장 높습니다. 반면 코딩 시험(FrontierSWE 2)은 61.2%로 GPT-6 Astra의 65.5%보다 낮고, 컴퓨터 조작 시험(OSWorld-2.1)도 81.5%로 Opus 5.5의 87.2%에 못 미칩니다 [공식 문서].
그런데 이 표의 Claude Fable은 5.2가 아니라 5.1입니다. 10월 기준 표라서 그렇습니다. 그래서 Fable 5.2가 들어간 독립 측정을 봐야 합니다. [커뮤니티 보고]
- Artificial Analysis 종합 지수: 카본 60점, 74개 중 4위. 위 세 줄은 모두 effort(얼마나 깊이 생각할지 정하는 설정)만 다른 Fable 5.2이고, 최고 설정이 65점입니다. 모델 단위로 세면 카본이 두 번째입니다.
- Vals Index: 카본 70.45%로 3위, 1위는 Fable 5.2(71.31%).
- Arena 웹 개발: 1768점으로 4위(잠정).
- ARC-AGI: 버전 2는 카본 94.2% 대 Fable 5.2 93.8%로 카본이 근소하게 앞서고, 버전 3은 65.1% 대 81.2%로 Fable이 앞섭니다.
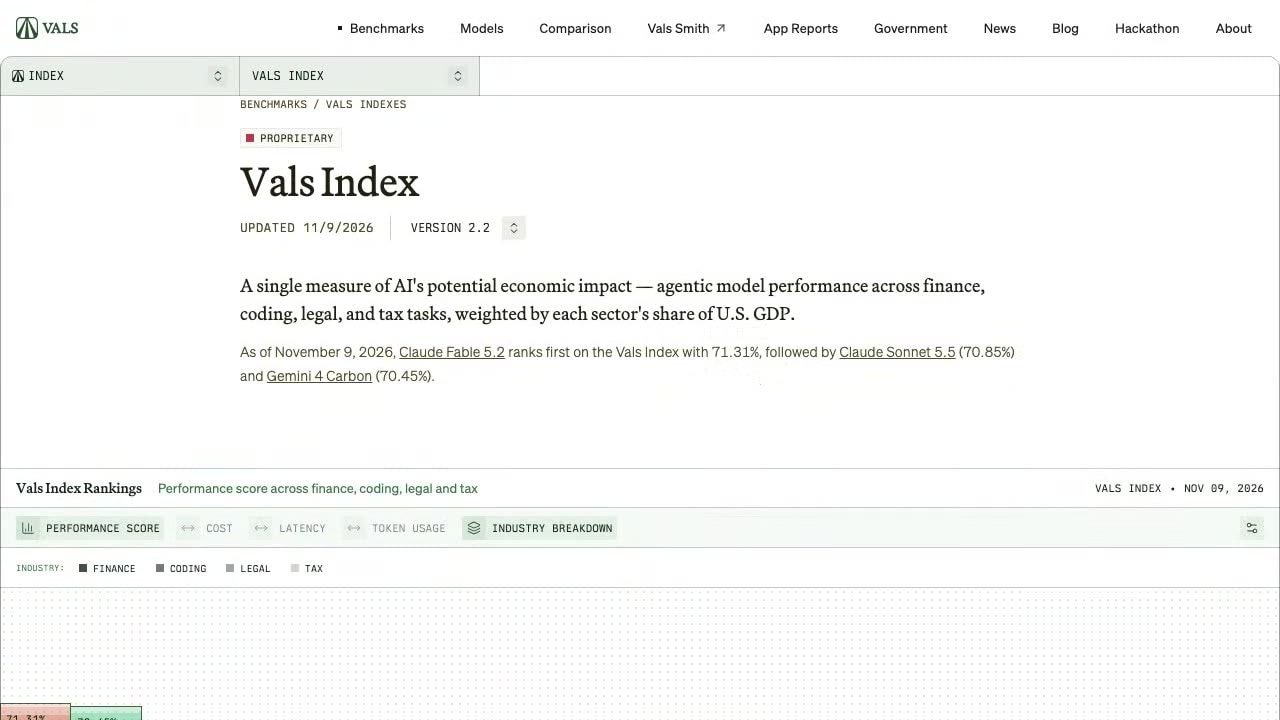
시험마다 앞서는 모델이 다릅니다.
5. 진짜 값: 과제당 비용
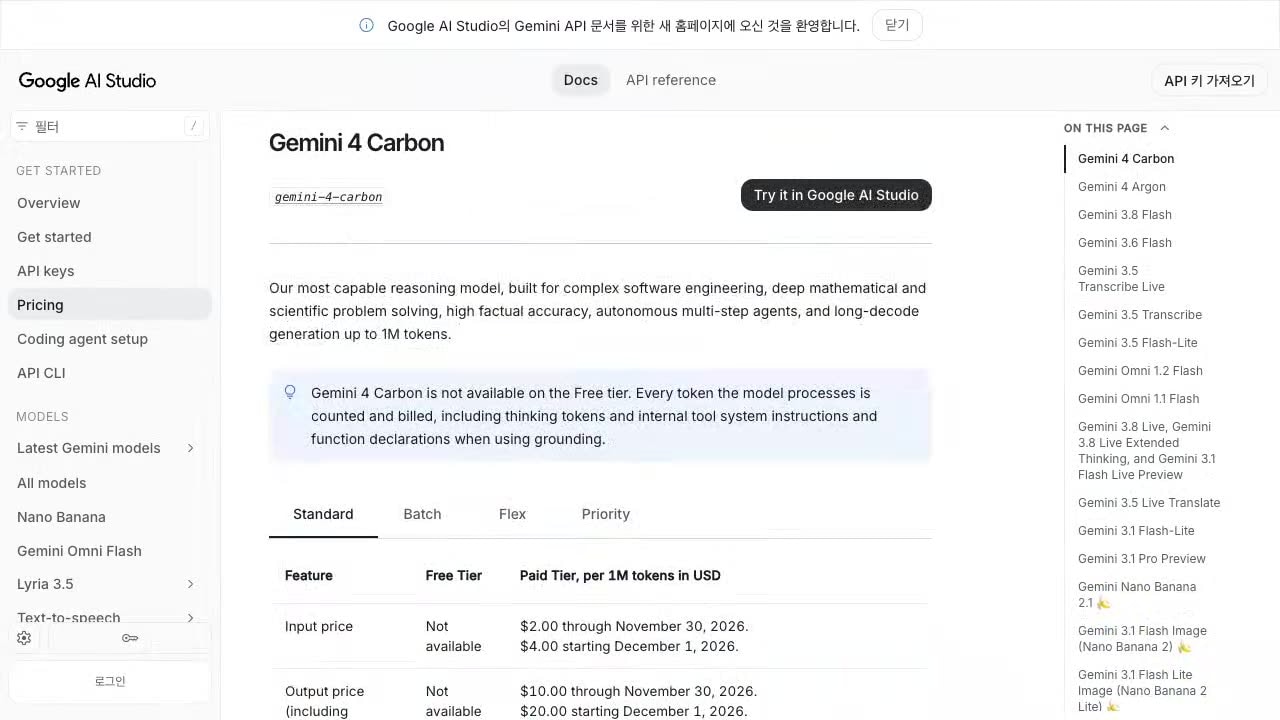
먼저 가격표입니다. 카본은 100만 토큰당 입력 2달러, 출력 10달러입니다. 이 출시 가격은 11월 30일에 끝나고, 12월 1일부터 4달러·20달러로 정확히 두 배가 됩니다 [공식 문서]. 12월 단가는 Opus 5.5와 같고, 8달러·40달러인 Fable 5.2의 절반입니다 [공식 문서].
그런데 가격표의 단가와 실제로 내는 돈은 다릅니다. 일 하나를 끝낼 때까지 든 돈, 즉 과제당 비용은 단가 × 모델이 쓴 토큰 수입니다. 토큰을 많이 쓰는 모델은 단가가 싸도 비싸질 수 있습니다.
| 측정 | 카본 | 비교 대상 | 차이 |
|---|---|---|---|
| Artificial Analysis, 12월 단가, 같은 high 설정 | $7.76 | Fable 5.2 high $9.08 | 약 15% 쌈 |
| Artificial Analysis, 12월 단가 | $7.76 | Fable 5.2 최고 설정 $26.54 (5점 높음) | 약 3분의 1 |
| Vals AI, 테스트당 | $10.51 | Fable 5.2 $17.94 | 약 41% 쌈 |
[커뮤니티 보고] 단가는 절반인데 같은 설정의 Fable보다 15%만 싼 이유는 토큰입니다. Artificial Analysis 지수 전체를 돌리는 데 카본이 쓴 출력 토큰은 비슷한 모델 중앙값의 약 2.8배였고, 시간도 26.1분 대 16.9분으로 약 1.5배 걸렸습니다.
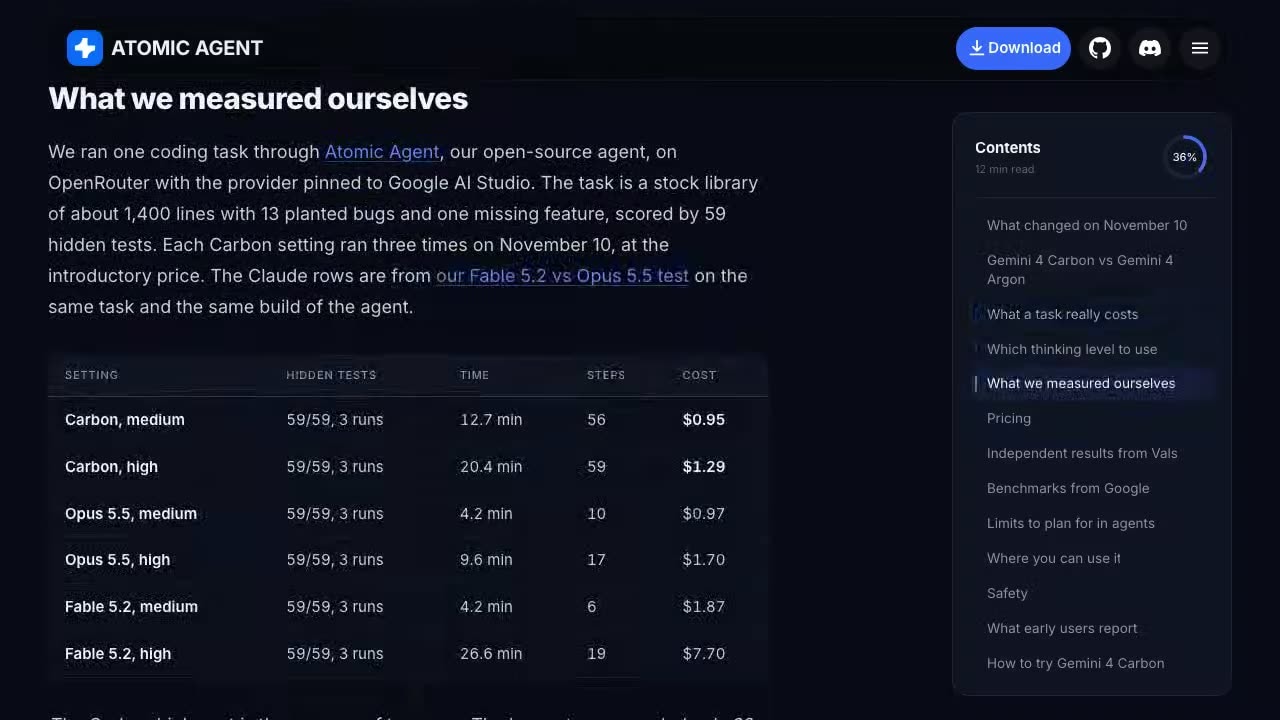
Atomic Agent는 코딩 과제 하나를 깊게 쟀습니다. 버그 13개를 고치고 빠진 기능 하나를 채우는 과제로, 세 모델 모두 숨은 테스트 59개를 전부 통과했습니다. [커뮤니티 보고]
| 모델 (high) | 비용 | 시간 |
|---|---|---|
| 카본 | $1.29 | 약 20분 |
| Opus 5.5 | $1.70 | 약 10분 |
| Fable 5.2 | $7.70 | 약 27분 |
여기엔 조건이 있습니다. 카본 비용은 11월 출시 가격 기준이고, 세 번 중 두 번의 평균입니다. 12월 단가로 바꾸면 약 2.6달러가 되어, 같은 high 설정의 Opus 5.5보다 비싸집니다.
결국 얼마나 싼지는 무엇과 견주느냐에 달렸습니다.
6. 약점: 속도
- Artificial Analysis 측정으로 첫 답이 나올 때까지 66초가 걸렸습니다. 비슷한 모델 중앙값은 12초입니다 [커뮤니티 보고].
- 앞에서 본 codeSTACKr의 한 줄 버그 수정도 68분 대 15분이었습니다 [커뮤니티 보고].
- 개발자 커뮤니티 Hacker News에는 "긴 작업용이지 대화용은 아니다", "Ultra 요금제로 프로젝트 하나를 겨우 끝냈다"는 댓글이 있습니다 [커뮤니티 보고].
- 구글 모델 카드에도 가끔 느리거나 시간 초과가 날 수 있다고 적혀 있습니다 [공식 문서].
7. 어느 요금제부터 쓸 수 있나
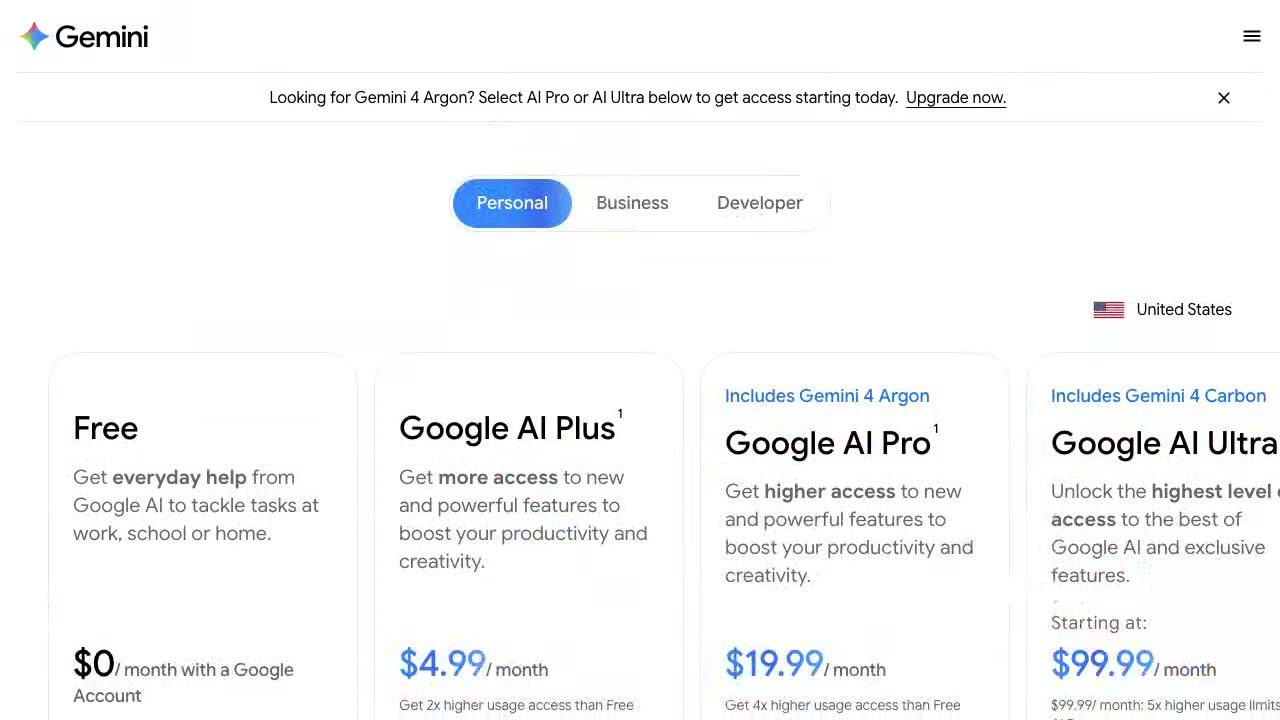
구글 구독 페이지의 미국 표시 가격 기준입니다 [공식 문서].
| 요금제 | 월 가격 | 카본 |
|---|---|---|
| 무료 | $0 | 없음 |
| Google AI Plus | $4.99 | 없음 |
| Google AI Pro | $19.99 | 없음 (아르곤까지) |
| Google AI Ultra | $99.99 (Pro의 5배 한도) / $199.99 (20배 한도) | 있음 |
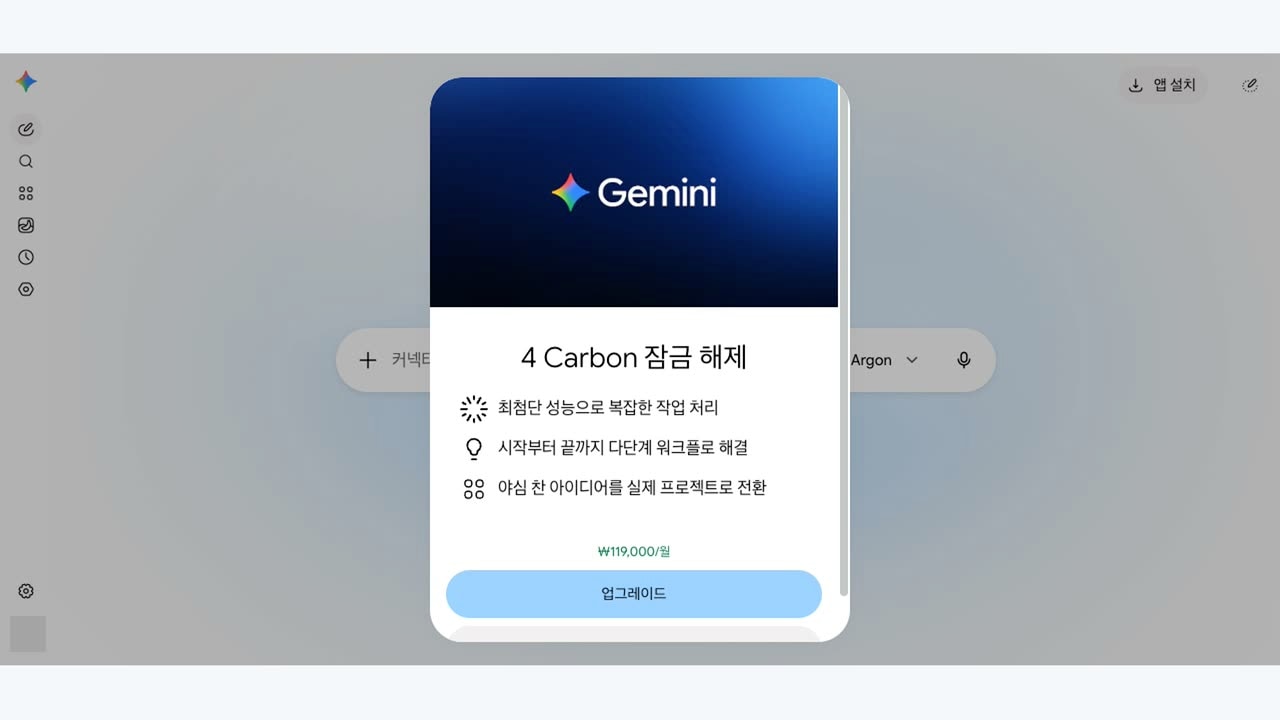
Pro 요금제 계정에서 제미나이 앱 모델 메뉴의 카본을 누르면 잠금 해제 창이 뜨고, 한국 계정 화면에는 월 11만 9천 원으로 나옵니다 [직접 측정].
구독 말고 다른 길도 있습니다 [공식 문서].
- Gemini API: 무료 티어는 없고 유료 티어로만 열려 있습니다.
- 기업: Gemini for business로 쓸 수 있습니다.
- 과학자: 신청해서 선정되면 6개월 무료입니다.
- 보안 방어자: Fairwind 프로그램에 신청할 수 있습니다.
8. 고르는 기준과 한계
정리하면 이렇습니다.
- 이번에 본 측정에서 과제당 비용은 Fable 5.2보다 쌌습니다. 다만 폭은 15% 싼 데서 3분의 1 값까지, 견주는 설정마다 달랐습니다.
- Opus 5.5보다 싼지는 12월 단가에서 갈립니다. Atomic Agent 과제는 12월 단가로 바꾸면 Opus 5.5가 더 쌉니다.
- 느립니다. 첫 답까지 66초입니다. 그래서 몇 시간 맡겨 둘 긴 작업이나 보안 리뷰라면 후보이고, 대화하며 빠르게 고치는 개발에는 구글 말대로 아르곤이 맞습니다. 아르곤은 Pro 요금제에 들어 있습니다.
- API로 시험해 보려면 출시 가격인 11월 안에 해 보되, 예산은 12월 단가로 잡는 편이 안전합니다.
한계도 분명합니다.
- 이 글의 사용 사례는 모두 다른 분들이 돌린 결과이고, 저희가 같은 조건으로 재현하지 않았습니다. 한두 번 돌린 결과가 대부분입니다.
- 성능 숫자 상당수는 구글이 직접 잰 것입니다. 독립 측정도 사이트마다 방법이 달라 숫자를 바로 견주면 안 됩니다.
- 리더보드는 계속 바뀝니다. 숫자는 2026년 11월 11일에 본 값이고, 읽는 날짜의 원 페이지를 꼭 다시 확인하세요.
가격표의 반값이 과제의 반값은 아니었습니다.
영상으로 보기
먼저 써 본 개발자들의 실제 결과 화면과 리더보드, 요금제 화면을 영상으로 정리했습니다.
출처
구글 (공식 문서)- Google, Introducing Gemini 4 Carbon (2026-10-28) — 목적, 스웜, 공식 데모
- Google, Gemini 4 Carbon is now available (2026-11-10) — 일반 공개, 아르곤 권장, 쓸 수 있는 곳
- Google DeepMind, Gemini 4 Carbon 모델 카드 — 비교 표, 제한 사항
- Google DeepMind, Gemini 4 Carbon 안전·보안 보고서 (PDF) — 아르곤 평가 승계, 정직성 70%→92%
- Google AI Studio, Gemini API 가격 — 11월·12월 단가, 무료 티어 없음
- Google, Gemini 구독 — 요금제별 포함 모델
- Artificial Analysis — Gemini 4 Carbon — 지수, 과제당 비용·시간, 출력 토큰, 첫 답 시간, 환각
- Vals AI — Vals Index — 종합 점수, 테스트당 비용
- Arena 리더보드 — 텍스트·웹 개발 점수
- ARC Prize 리더보드 — ARC-AGI-2·3
- Atomic Agent — Gemini 4 Carbon — 코딩 과제 1개 비용·시간
- Hacker News 스레드 — 사용자 반응
- codeSTACKr × LiveKit, Gemini 4 Carbon Built This Voice Assistant in 4.5 Hours
- Sam Witteveen, Gemini 4 Carbon is Live!
- Paul J Lipsky, Gemini 4 Carbon Is Here (Fully Tested)
- Bijan Bowen, Gemini 4 Carbon 테스트
- Simon Willison, llm-gemini 0.36