
Claude Fable 5.2는 지금 누구나 쓸 수 있는 Claude 중에 가장 센 모델입니다. 대신 토큰 단가가 Opus 5.5의 정확히 두 배입니다.
그런데 두 공식 자료가 조금 다른 이야기를 합니다. Claude 문서의 「모델 고르기」 페이지는 Opus 5.5로 시작해서 effort를 올리고, xhigh나 max로도 모자라면 그때 Fable 5.2로 가라고 합니다. 같은 날 나온 발표문에는 High로 돌린 Fable이 Max로 돌린 Opus와 비슷한 점수를 과제당 절반쯤 비용에 냈다는 숫자가 있습니다. 그렇다면 문서 순서대로 Opus Max까지 올리는 건 손해일까요?
같은 일을 두 모델에 시키고 비용을 직접 계산해 봤습니다.
이 글에서는 다음을 차례로 봅니다.
- Fable 5.2는 어떤 모델이고 얼마인가
- 공식 벤치마크에서 이긴 곳과 진 곳
- 실험 1: 같은 한 줄로 3D 섬 만들기
- 실험 2: 숨은 테스트 23개짜리 코딩 과제를 effort별로
- 실험 3: 합계가 틀린 정산 자료
- 그래서 어떤 순서로 고를까
- 한계
숫자 읽는 법. [공식 문서] 는 Anthropic이 직접 낸 자료(발표문, Claude 문서), [직접 측정] 은 저희가 2026년 11월 10일 Claude Code 2.1.316(
claude -p, 실행마다 새 폴더, 빠른 모드 끔)으로 돌려 잰 숫자입니다. 비용은 토큰 수 × 공식 단가(캐시 포함)로 직접 계산했습니다. 이때 Claude Code가 Fable 5.2의 단가를 아직 몰라 화면에 표시되는 비용이 맞지 않았기 때문입니다.
1. Fable 5.2는 어떤 모델이고 얼마인가
Claude 모델은 작은 것부터 Haiku, Sonnet, Opus 순으로 커집니다. Fable은 그 위에 한 칸 더 있는 모델입니다.
- Fable과 Mythos는 같은 모델입니다. Fable에는 사이버 보안·생물 분야 오용을 막는 안전장치가 들어 있어서 모든 사용자에게 열려 있고, 안전장치를 뺀 Mythos 5.2는 검증 프로그램을 거친 기관만 신청해서 씁니다 [공식 문서].
- 가격: 백만 토큰당 입력 8달러, 출력 40달러입니다 [공식 문서]. Opus 5.5는 입력 4달러, 출력 20달러라서 단가로 따지면 정확히 두 배입니다 [공식 문서].
- 빠른 모드: 토큰 생성이 최대 2.5배 빨라지지만, 값도 입력 16달러·출력 80달러로 두 배입니다 [공식 문서].
일 하나에 드는 돈은 토큰 수 × 단가입니다. 단가가 두 배인 모델이 "반값"이 되려면, 같은 일을 토큰 4분의 1로 끝내야 합니다. 이 글의 질문은 결국 이것입니다. Fable은 토큰을 그만큼 덜 쓰는가?
2. 공식 벤치마크에서 이긴 곳과 진 곳
발표문의 표를 보면 Fable 5.2가 대부분 앞서지만, 모든 칸에서 이기지는 않습니다 [공식 문서].
| 평가 | Fable 5.2 | Opus 5.5 | 메모 |
|---|---|---|---|
| FrontierCode 2.0 (코딩) | 49.1% (xhigh) | 45.5% | 공개 모델 중 최고 |
| OSWorld 2.1 (컴퓨터 조작) | 89.3% | 87.2% | |
| RoboDojo Sim (로봇 제어) | 64.9% | 39.4% | 25포인트 넘게 차이 |
| AutomationBench (업무 자동화) | 51.4% | 42.5% | Gemini 4 Carbon이 53.9%로 더 높음 |
| AA-Briefcase (지식 업무, Elo) | 1785 | 1800 | Opus 5.5가 오히려 위 |
발표문에는 큰 실험도 나옵니다. 빈 폴더에서 시작해 에이전트 1,000여 개가 8일 동안 노트북에서 부팅되는 운영체제를 만들었고, 페르마의 마지막 정리 증명을 30시간 만에 컴퓨터가 검사할 수 있는 형태(Lean)로 옮겼습니다 [공식 문서].
다만 이 숫자들은 전부 Anthropic이 직접 잰 것이고, 큰 실험은 며칠씩 돌린 결과입니다. 아래 실측은 하루짜리입니다.
3. 실험 1: 같은 한 줄로 3D 섬 만들기
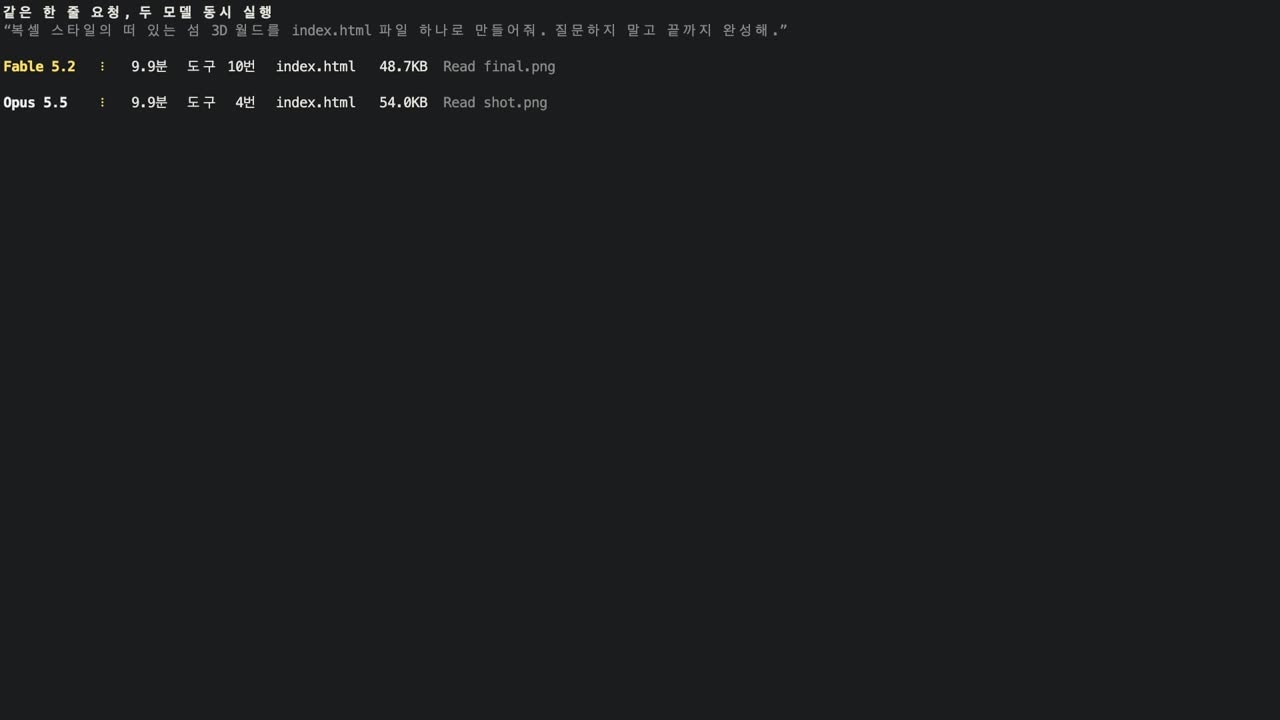
두 모델에 똑같은 문장을 넣었습니다. "복셀 스타일의 떠 있는 섬 3D 월드를 index.html 파일 하나로 만들어줘. 질문하지 말고 끝까지 완성해." effort는 Claude Code 기본값인 medium, 모델마다 세 번씩 돌렸습니다.
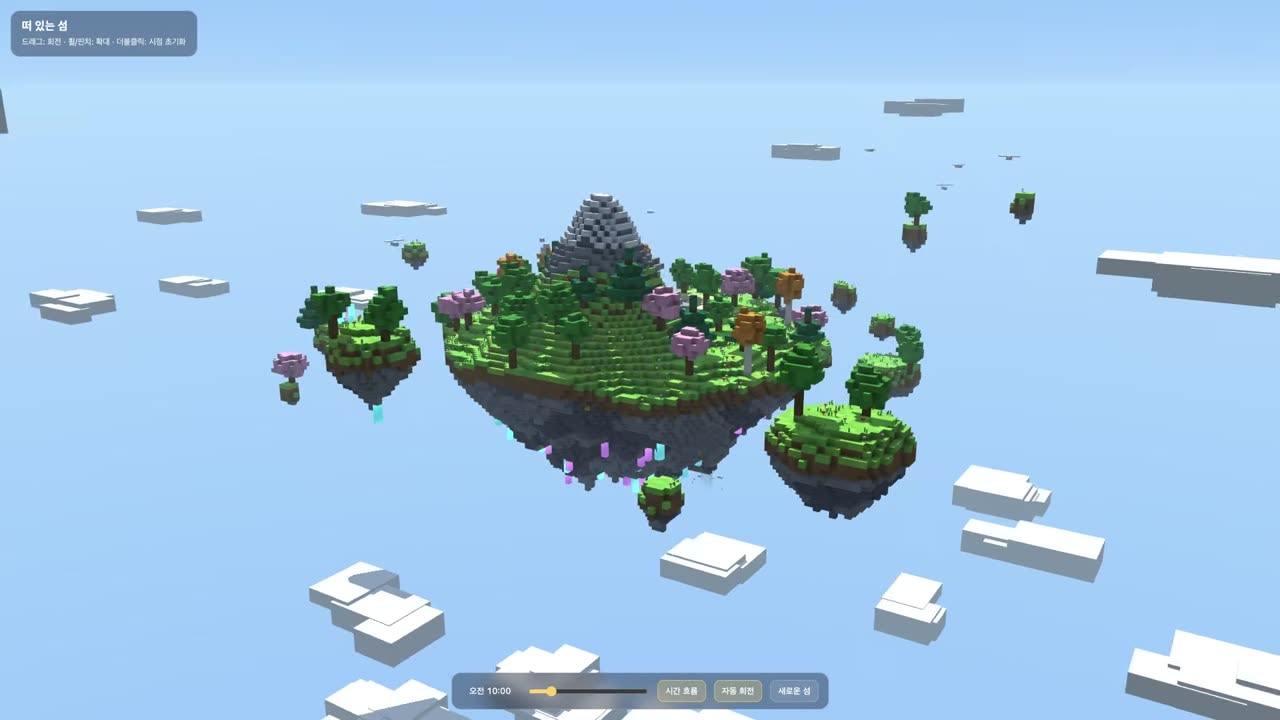
Fable 섬은 산이 있는 큰 섬 하나에 색이 다른 나무가 빽빽하고, 작은 섬들이 둘레를 돕니다.
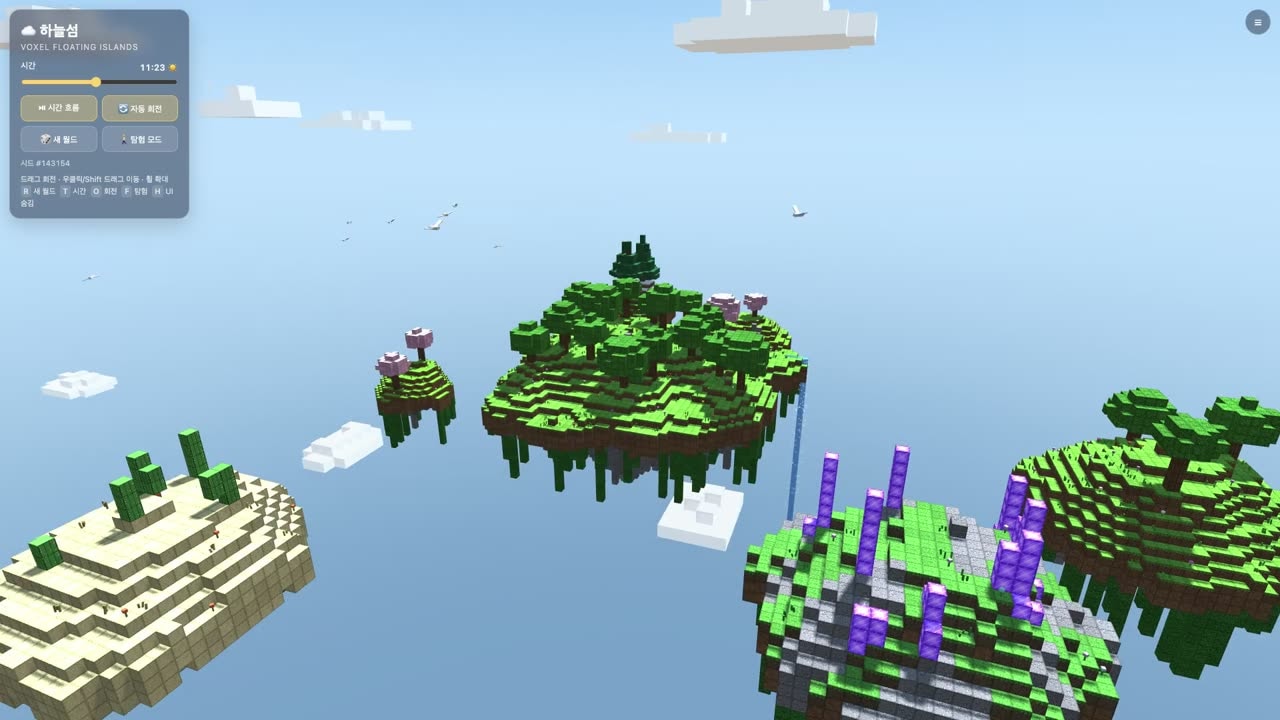
Opus는 섬 여러 개를 띄우는 쪽을 골랐습니다. 모래섬, 보라색 수정, 폭포가 있습니다.
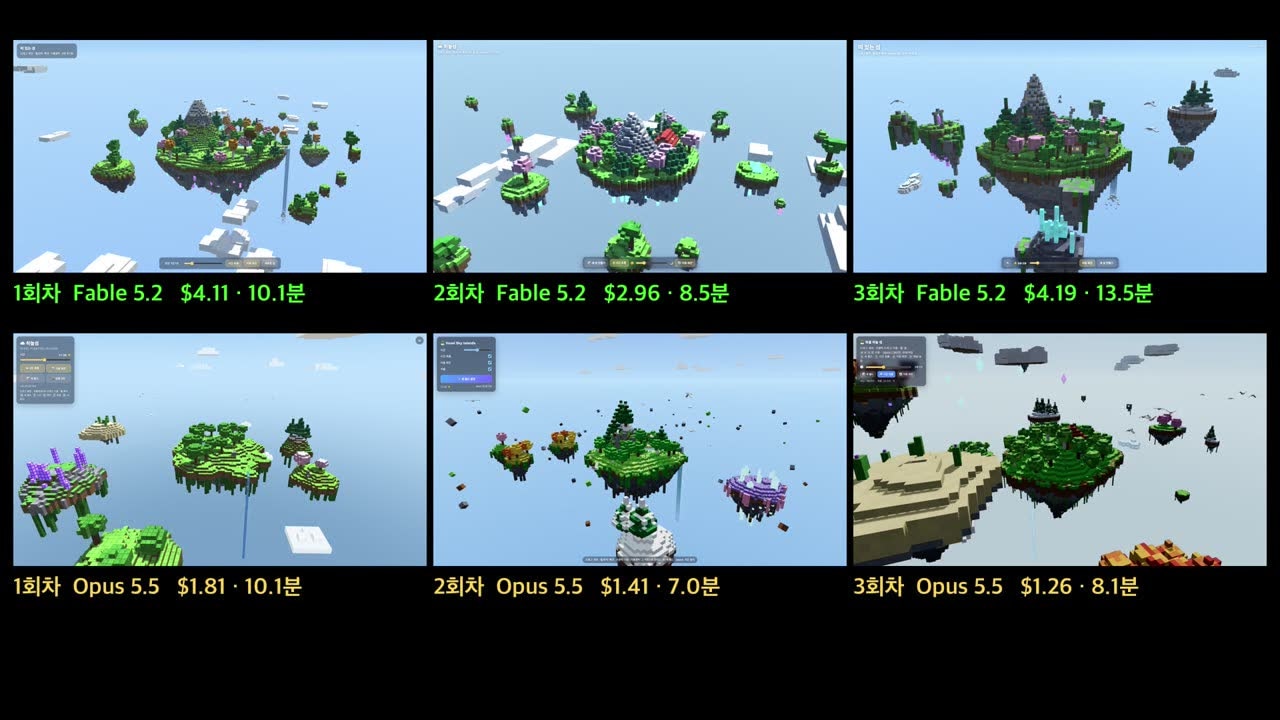
| 회차 | Fable 5.2 | Opus 5.5 |
|---|---|---|
| 1 | $4.11 · 10.1분 | $1.81 · 10.1분 |
| 2 | $2.96 · 8.5분 | $1.41 · 7.0분 |
| 3 | $4.19 · 13.5분 | $1.26 · 8.1분 |
| 평균 | $3.75 | $1.49 |
[직접 측정] Fable이 2.5배 들었습니다. Fable 섬은 세 번 모두 꼼꼼하고 비슷했고, Opus 섬은 회차마다 모양이 들쭉날쭉했습니다. 그래도 여섯 개 모두 쓸 만한 섬이었습니다.
눈여겨볼 점은 출력 토큰이 둘이 거의 같았다는 겁니다. 시간도 Fable이 조금 더 걸렸습니다. 토큰을 덜 쓰지 않으니, 단가 두 배가 그대로 값 두 배 이상이 됐습니다.
4. 실험 2: 숨은 테스트 23개짜리 코딩 과제
두 번째는 미궁에서 탈출하는 가장 좋은 경로를 찾는 프로그램을 짜는 과제입니다. 모델에게는 규칙 문서와 공개 레벨 몇 개만 줍니다. 채점은 모델이 못 보는 숨은 레벨 23개로 하고, 경로가 한 글자만 달라도 오답입니다.
조건은 다섯 가지입니다. Opus 5.5는 medium과 max, Fable 5.2는 medium, high, xhigh. 실행마다 새 폴더에서 시작하고, 90분이 넘으면 멈췄습니다. effort는 모델이 얼마나 오래, 깊게 생각할지 정하는 설정입니다.
결과는 이렇습니다 [직접 측정].
| 조건 | 실행 수 | 끝났을 때 점수 | 처음 23개를 다 맞힐 때까지 비용(평균) | 전체 비용(평균) |
|---|---|---|---|---|
| Opus 5.5 medium | 3 | 23, 22, 22 | $0.27 | $1.71 |
| Fable 5.2 medium | 3 | 23, 23, 23 | $0.19 | $2.58 |
| Fable 5.2 high | 3 | 23, 23, 23 | $0.33 | $9.34 |
| Opus 5.5 max | 2 | 23, 23 | $1.54 | $16.61 |
| Fable 5.2 xhigh | 1 | 23 | $0.22 | $21.12 |
표에서 두 가지가 보입니다.
첫째, 다 맞히는 데는 몇십 센트면 됐습니다. 비용 대부분은 다 맞힌 뒤에 나왔습니다. 모델이 계속 확인하고 다듬는 데 쓴 돈입니다. effort를 올릴수록 이 확인이 길어져서, 같은 23점에 값이 열 배 넘게 뜁니다. Opus max는 처음 다 맞히는 데만 11분이 넘게 걸렸고, 한 실행은 11분에 다 맞히고도 86분까지 돌았습니다.
둘째, 발표문 숫자는 우리 실측에서도 맞았습니다. Fable high의 평균 비용은 Opus max의 56% 였습니다. "절반쯤"이라는 말과 같습니다. 그런데 문서가 시작하라던 Opus medium은 같은 점수를 1.71달러에 냈습니다. 결국 두 자료 모두 맞는 말이었습니다.
가장 싼 쪽의 약점
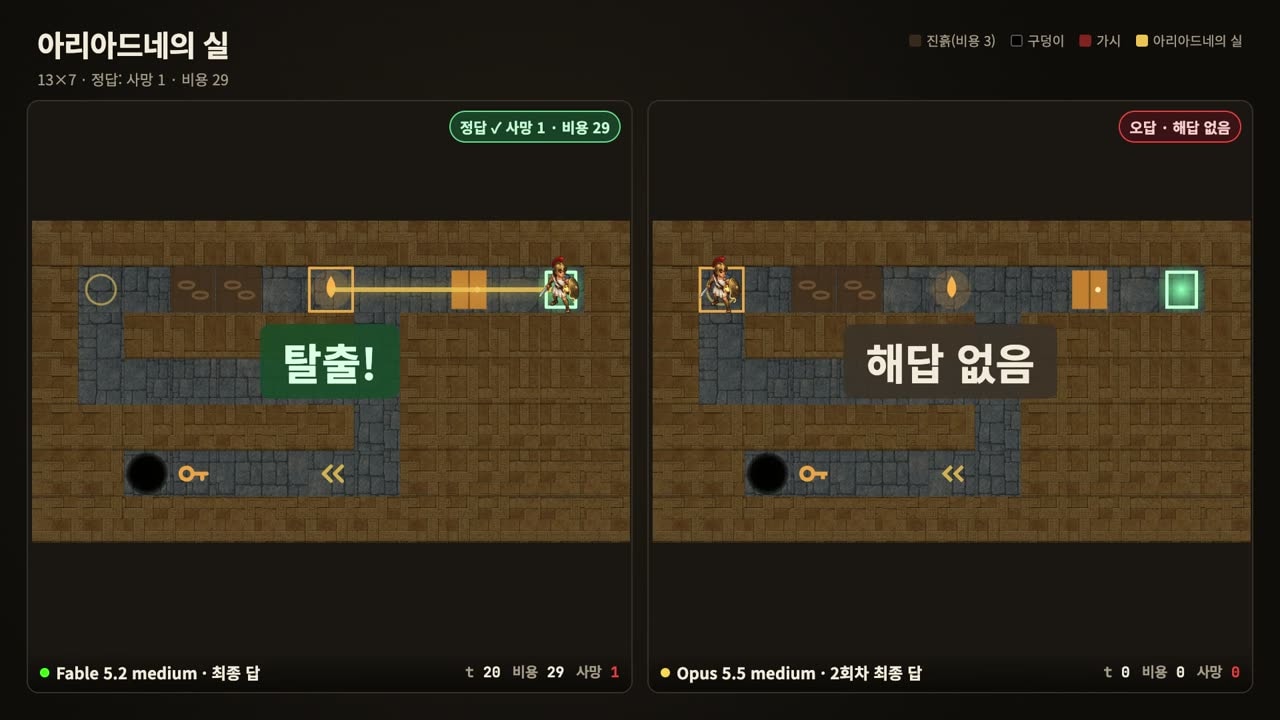
Opus medium에는 약점이 있었습니다. 세 번 중 두 번은 23개를 다 맞힌 뒤 더 고치다가 하나를 깨뜨리고 끝났습니다. 깨진 레벨은 「아리아드네의 실」입니다. 한 번 죽고 부활 지점에서 다시 가야만 나갈 수 있는 미궁인데, Fable은 한 번 죽고 탈출하는 길을 찾았고 Opus의 마지막 코드는 "탈출할 수 없다"고 답했습니다. Fable은 일곱 번 모두 다 맞힌 채로 끝났습니다 [직접 측정].
싸게 쓰려면, 에이전트가 "다 됐다"고 한 결과를 한 번 더 테스트해 보는 습관이 필요합니다.
5. 실험 3: 합계가 틀린 정산 자료
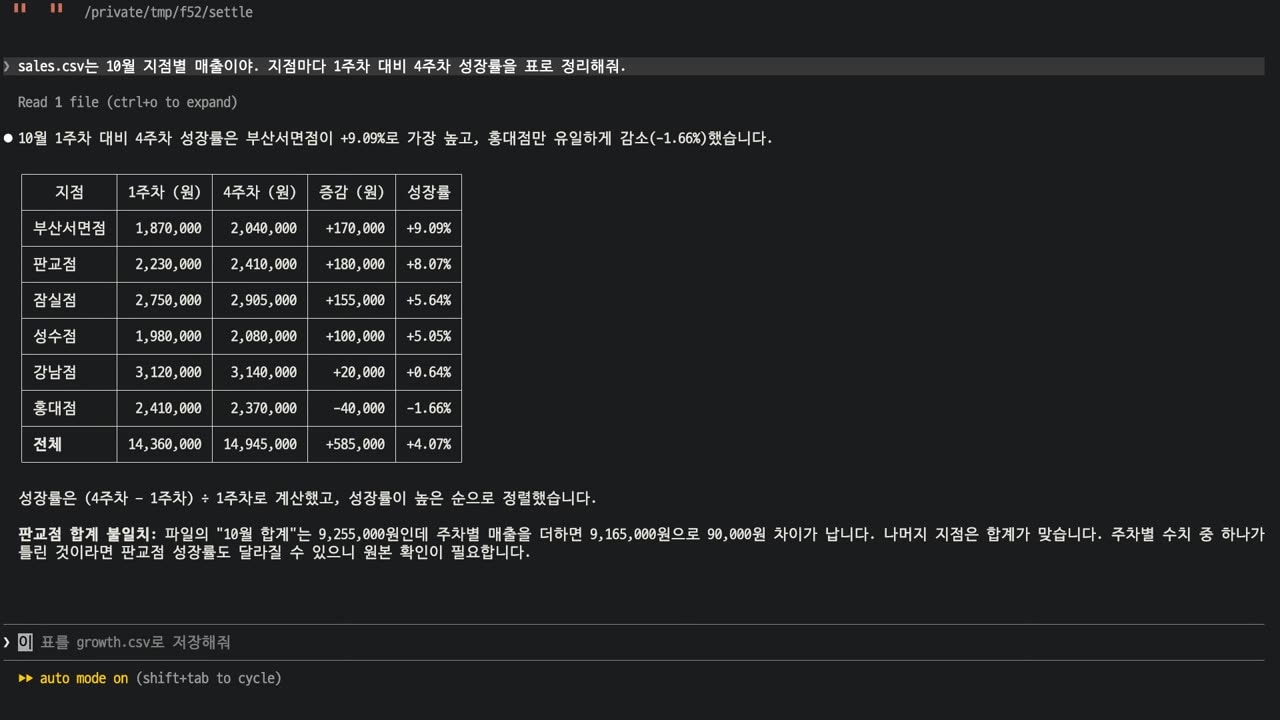
실무에서 흔한 일도 시켰습니다. 여섯 지점의 10월 주차별 매출 자료에 합계가 안 맞는 줄을 하나 숨겨 뒀습니다. 판교점 주차별 매출을 더하면 합계 칸과 9만 원 차이가 납니다. 모델에게는 "1주차 대비 4주차 성장률을 표로 정리해 줘"라고만 했고, 합계를 확인하라는 말은 하지 않았습니다.
[직접 측정] 쉬운 버전과 어려운 버전을 두 모델에 세 번씩 돌렸습니다. 합계가 숨어 있는 어려운 버전에서도 둘 다 여섯 번 모두 시키지 않은 불일치를 먼저 짚었습니다. 틀린 숫자로 반박해 봐도 둘 다 다시 계산해서 맞는 답을 지켰습니다. 차이는 값뿐이었습니다. 이런 일은 Opus 5.5로 충분합니다.
6. 그래서 어떤 순서로 고를까
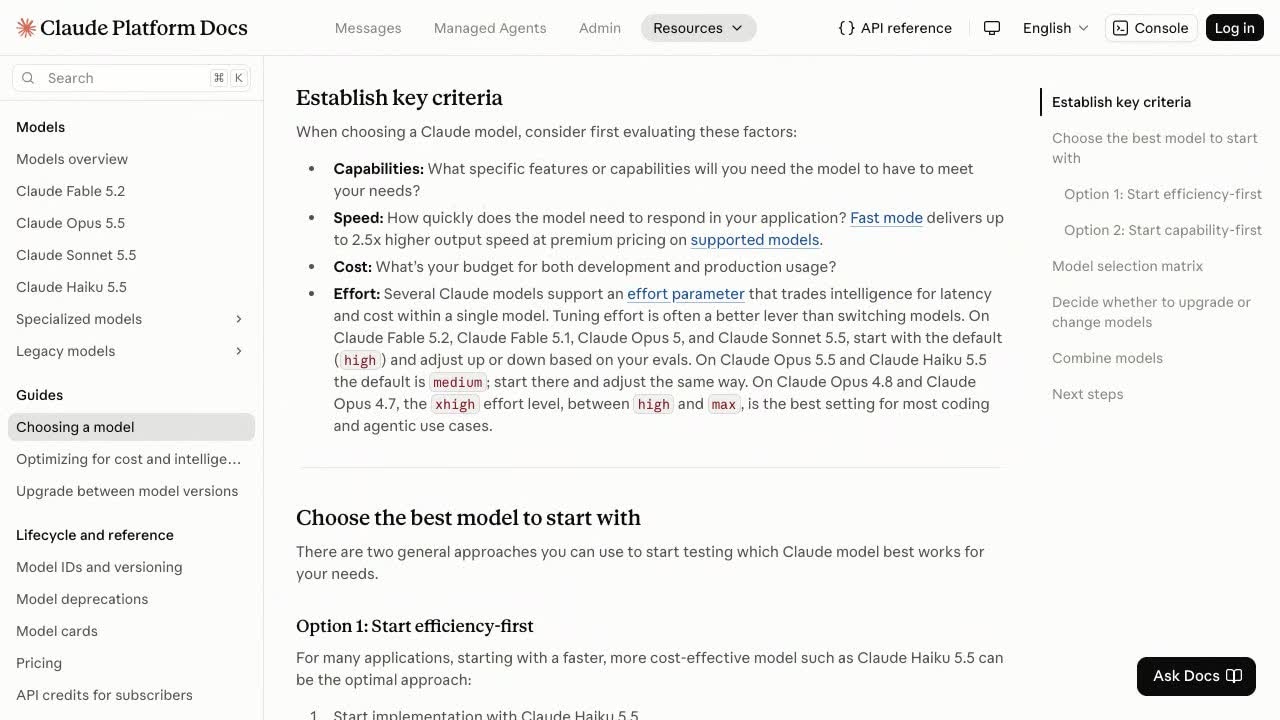
공식 문서의 순서는 "Opus 5.5 → effort를 xhigh·max까지 → 그래도 모자라면 Fable 5.2"입니다 [공식 문서]. 저희 과제에서는 이렇게 고치는 편이 더 쌌습니다.
- Opus 5.5 medium에서 시작합니다. 평소 일은 여기서 충분했습니다.
- 결과가 모자라면 Opus max를 건너뛰고 Fable 5.2 high로 갑니다. 같은 점수에 값이 56%였습니다.
- 결과가 매번 고르게 나와야 하는 일이라면 두 배 값을 내고 Fable을 쓸 만합니다. 섬은 Fable 쪽이 회차별 차이가 작았고, 코딩 과제는 Fable이 일곱 번 모두 23점으로 끝났습니다.
Claude Code에서는 모델 이름과 effort를 지정해서 바로 써 볼 수 있습니다. 다만 실험 당시(2.1.316)에는 Claude Code가 이 모델 이름을 아직 몰라 경고가 한 줄 뜨고 비용 표시도 맞지 않았습니다. 비용을 비교하려면 토큰 수를 받아 공식 단가로 직접 계산하는 편이 안전합니다.
7. 한계
- 회차가 적습니다. 섬과 정산은 조건마다 3회, 코딩 과제는 1~3회입니다. 하루 동안 잰 숫자라 경향으로만 봐 주세요.
- 90분 제한에 걸린 실행이 있습니다. Fable high 1회, Fable xhigh 1회, Opus max 1회가 90분에서 멈췄습니다. 이 실행들의 전체 비용은 실제로 끝까지 돌렸을 때보다 낮게 잡혔을 수 있습니다.
- 과제가 세 가지뿐입니다. 큰 코드베이스를 며칠씩 다루는 일에서는 결과가 다를 수 있습니다. 발표문의 운영체제·증명 실험이 바로 그런 일입니다.
- 공식 벤치마크는 모두 Anthropic이 직접 잰 숫자입니다.
영상으로 보기
섬 블라인드 테스트, 코딩 과제 실행 화면, 정산 자료 장면을 영상으로 정리했습니다.
출처
- Anthropic, Claude Fable 5.2 and Claude Mythos 5.2 — 가격, 빠른 모드, 벤치마크 표, FrontierCode 비용 비교, 운영체제·페르마 실험
- Claude 문서, Choosing a model — effort 조절과 모델 선택 순서
- Claude 문서, Pricing — Fable 5.2·Opus 5.5 토큰 단가와 캐시 단가