
Claude Code에 "요약 패널 넣어 줘"라고 하면 요약 패널이 생기고 테스트도 통과합니다. 그런데 그 패널을 보고 무엇을 해야 할지는 여전히 알 수 없을 때가 있습니다. 시킨 일은 정확히 했는데, 정말 원했던 결과는 아닌 거죠.
Anthropic의 Felix Rieseberg는 10월 13일에 이 문제를 다룬 글 「How to be more ambitious」를 올렸습니다. 같은 모델을 쓰는데 어떤 사람은 놀라운 결과를 내고, 어떤 사람은 이메일 말투를 고치는 데 머문다는 이야기입니다. 그의 방법을 실제 프로젝트에 하나씩 써 봤습니다.
이 글에서는 다음을 차례로 봅니다.
- 왜 시킨 만큼만 나오나, 그리고 네 가지 야심
- 고도: 할 일에 목표 한 줄을 붙이면
- 깊이: 부탁을 다시 쓰게 하고 끝까지 만들기
- 바깥 심판: 2000개라던 검증이 381개였다
- 범위: 명사를 동사로 바꾸고 여러 분야의 눈으로 보기
- 이 방법들이 통하려면 Claude에게 줘야 할 것
- 이번 실습의 한계
숫자 읽는 법. [공식 문서] 는 당사자가 직접 쓴 자료(이 글에서는 펠릭스의 글), [논문] 은 공개 논문, [직접 측정] 은 저희가 이번 실습에서 직접 돌려 본 결과입니다. 실습은 Claude Code(Opus 5.5)로 했고, 바깥 심판은 Codex CLI가 맡았습니다.
1. 왜 시킨 만큼만 나오나
Felix Rieseberg(이하 펠릭스)는 Anthropic의 엔지니어링 매니저로, Claude.ai·Cowork·Claude Code Desktop 개발을 이끌었고 Electron 공동 관리자이기도 합니다 [공식 문서] (펠릭스의 글).
우리는 보통 AI를 할 일 목록처럼 씁니다. 이거 만들어 줘, 저거 고쳐 줘. 프롬프트에 원하는 결과가 없으니 AI는 그 일을 하고 끝났다고 말합니다. 반대로 이루고 싶은 결과를 알려 주면, 만든 것을 그 목표와 비교해 모자란 곳을 다시 고칠 수 있습니다.
펠릭스는 사람도 비슷하다며 목표 설정 연구를 인용합니다. Locke와 Latham이 35년 치 연구를 정리한 결과, 구체적이고 어려운 목표를 받은 사람이 "최선을 다하라"는 말을 들은 사람보다 더 잘했다는 내용입니다 [논문] (Locke & Latham 2002).
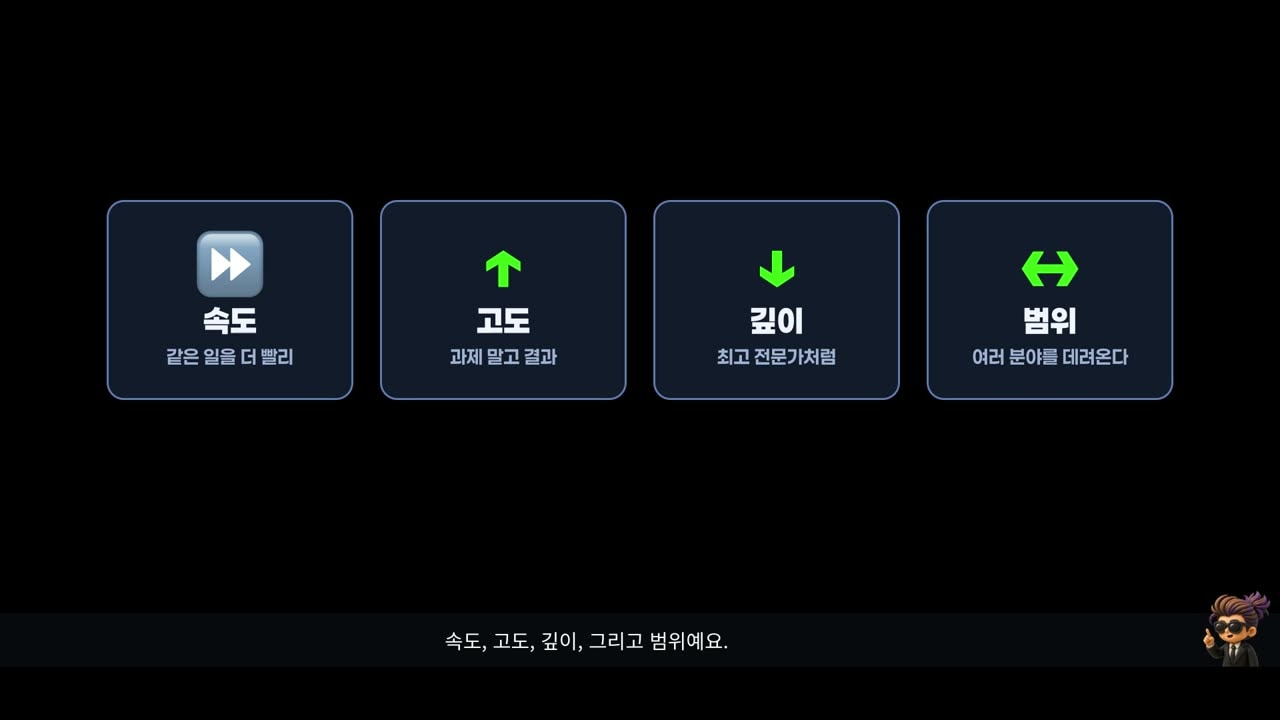
그는 야심을 네 가지로 나눕니다 [공식 문서].
- 속도(Speed): 같은 일을 더 빨리 합니다. 다들 이미 하고 있어서 글에서도 넘어갑니다.
- 고도(Altitude): 할 일 대신 결과를 맡깁니다.
- 깊이(Depth): 그 분야 최고 전문가처럼, 한 층 아래의 데이터와 도구까지 내려갑니다.
- 범위(Range): 겉으로 필요한 분야 말고 다른 분야의 지식과 기법까지 끌어옵니다.
나머지 세 가지를 ComfySims에 써 봤습니다. 우리 집 도면 위에 사려는 가구를 실제 크기로 놓아 보고, 침대가 방문으로 들어가는지, 놓고 나서 지나다닐 수 있는지를 사기 전에 확인하는 오픈소스 앱입니다. 프롬프트 원문은 실습 저장소의 PROMPTS.md에 있습니다.
2. 고도: 할 일에 목표 한 줄을 붙이면
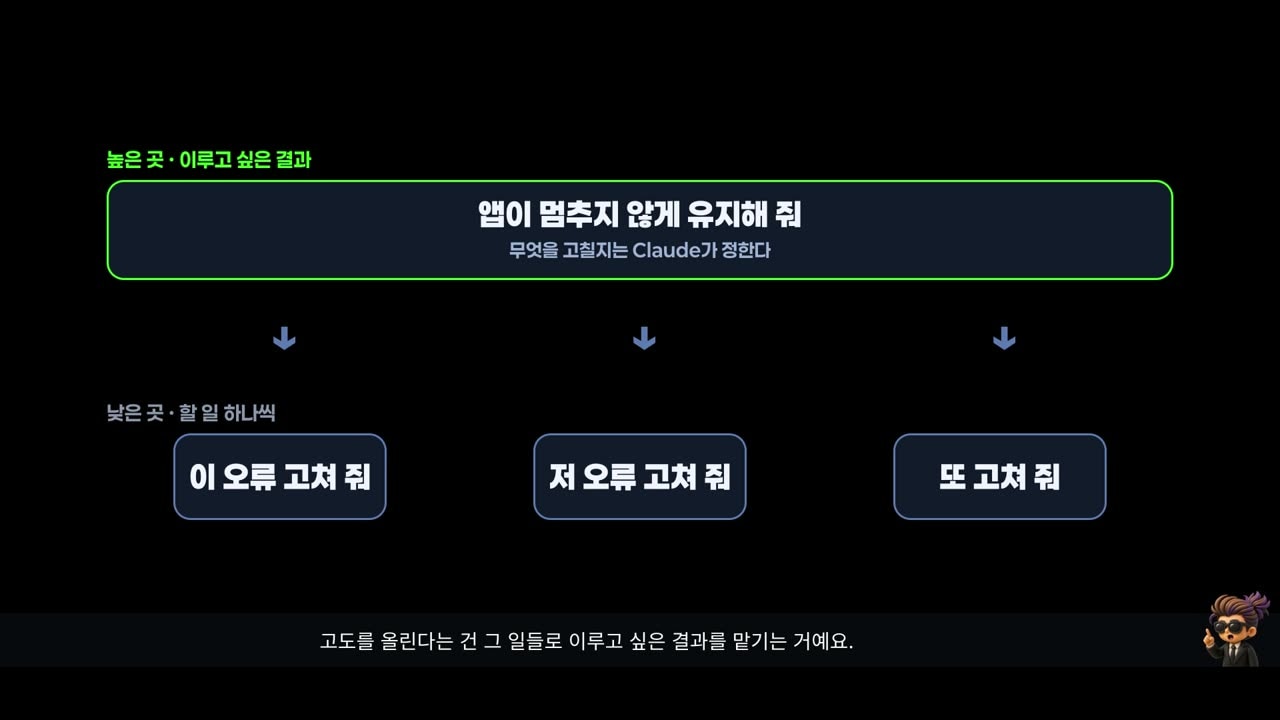
펠릭스도 작년 초까지는 앱이 멈추는 문제를 하나씩 고쳐 달라고 했다고 합니다. 지금은 앱이 멈추지 않게 유지해 달라고 합니다 [공식 문서]. 무엇을 고칠지는 Claude가 정합니다.
그래서 같은 "배치 요약 패널"을 두 번 만들어 비교했습니다. [직접 측정]
| 할 일만 줬을 때 | 할 일 + 목표 | |
|---|---|---|
| 프롬프트 | 편집기 오른쪽에 배치 요약 패널을 넣고 데모 집으로 확인 | 같은 할 일 + "사기 전에 정말 들어가고 지낼 만한지 확신하게 하는 것이 목적, 막는 것과 결정 세 가지를 보여 줘" |
| 결과 | 방마다 가구 수, 바닥 면적, 덮은 비율. 문제는 없다고 표시 | 패널 이름이 「사기 전에」로 바뀌고, 살 준비가 안 됐다고 맨 위에 표시 |
| 알게 된 것 | 이 표로는 무엇을 살지 알 수 없음 | 조리대가 서재·욕실 문을 막음, 퀸 침대는 통째로 못 들어감, 크기는 상품 링크가 없어 미확인 |
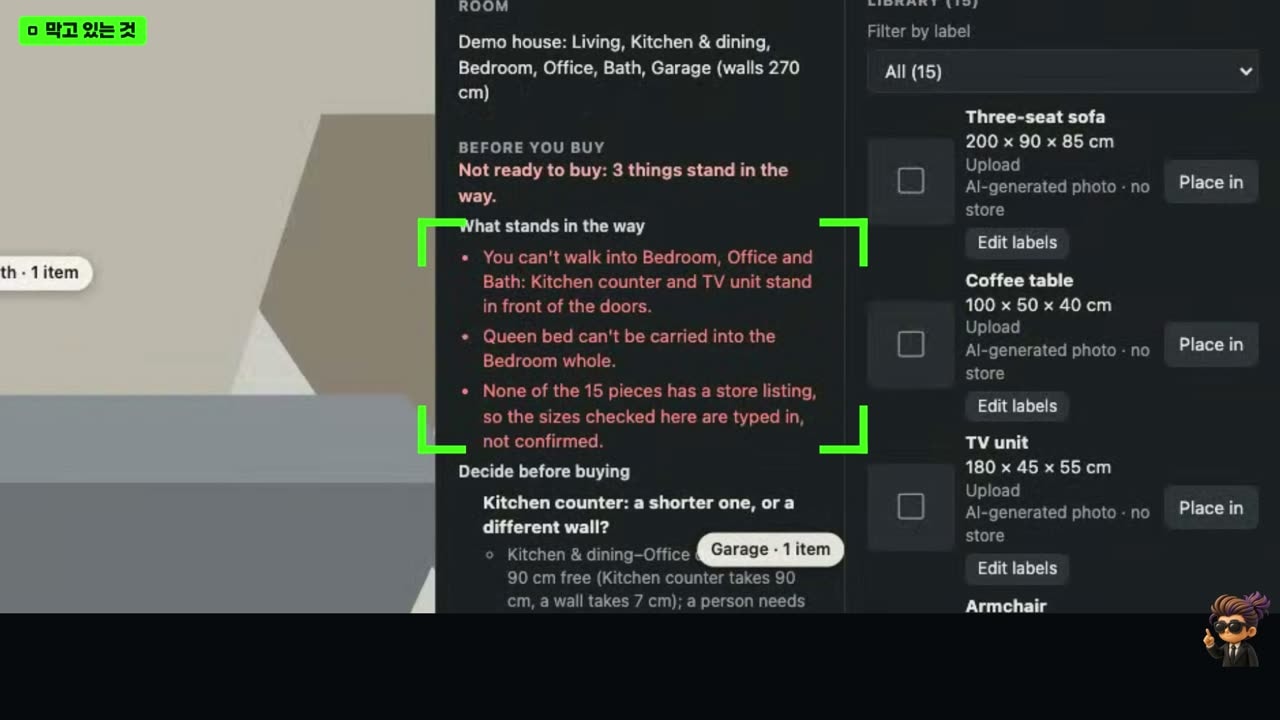
눈여겨볼 장면이 있습니다. 기존 검사는 문제가 없다고 하는데, 목표를 받은 Claude가 좌표를 직접 따져 보고 조리대가 문을 막고 있다고 말했습니다. 그 아래에는 "조리대는 130cm 이하로 사거나 다른 벽에 두기", "TV 장은 서쪽으로 20cm 옮기기"처럼 정할 것을 근거와 함께 적었습니다. 테스트 255개도 통과했습니다.
다만 펠릭스는 고도가 모든 일에 맞지는 않다고 합니다. 원하는 결과가 분명한 일, 회의를 열어 논의할 만한 일에 잘 맞고, 창작에는 덜 맞습니다. Claude에게 돈을 벌어 오라고 하는 건 아직 대부분 안 된다고 합니다 [공식 문서].
3. 깊이: 부탁을 다시 쓰게 하고 끝까지 만들기
전문가처럼 해 달라고 하면 말투만 바뀌고 일하는 방법은 그대로일 때가 많다고 합니다. 그래서 펠릭스는 그 분야 최고 전문가가 실제로 쓰는 도구를 쓰게 하라고 합니다. Claude가 마크다운 표를 그리려 하면 데이터베이스와 통계 모델을 쓰라고 하는 식입니다. 무엇을 쓰는지는 몰라도 됩니다. Claude가 보통 알고 있습니다 [공식 문서].
목표는 일부러 말도 안 되게 잡으라고도 합니다. 10초 걸리는 웹사이트를 5초 대신 200밀리초로 줄여 달라는 식입니다.
펠릭스가 자주 쓴다는 프롬프트도 있습니다(전문은 원문과 PROMPTS.md). 더 큰 버전 말고 더 깊은 버전을 원한다고 말한 뒤, 다시 쓰기 전에 네 가지를 답하게 합니다.
- 최고 전문가라면 내가 시키지 않은 무엇을 할까
- 이미 정리된 자료 말고 가장 원래의 자료는 무엇일까
- 어떤 방법과 도구를 쓸까
- 너나 나 말고 무엇이 결과가 맞다는 걸 보여 줄까
한 줄 부탁이 어떻게 바뀌었나
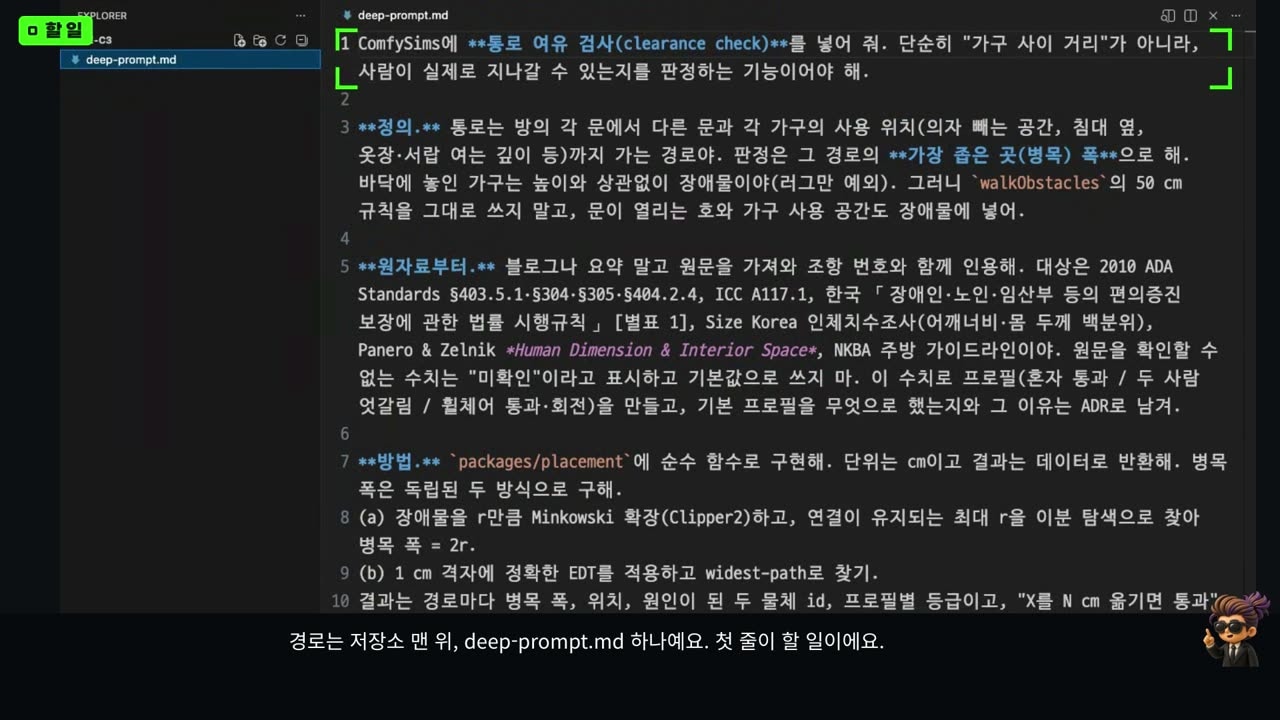
"가구 사이 통로가 지나다니기에 충분한지 확인하는 기능" 한 줄 아래에 이 프롬프트를 붙였습니다. Claude는 저장소부터 확인한 뒤 부탁을 파일 하나(deep-prompt.md)로 다시 썼습니다. [직접 측정]
- 정의: 통로 폭은 경로에서 가장 좁은 곳의 폭으로 잰다.
- 원자료: ADA(미국 장애인법) 기준과 한국 편의증진법 별표 같은 원문을 조항 번호와 함께 쓰고, 원문을 못 찾은 숫자는 미확인으로 표시한다.
- 맞다는 증거: 손으로 답을 아는 예제, 서로 다른 두 계산 방법 비교, 화면 확인 등 일곱 가지.
이 파일만 들고 앞 대화가 없는 새 세션을 열어 그대로 넘겼습니다.
새 세션이 한 일
- 몸 치수 자료는 원문을 찾지 못해, 그 숫자를 쓰지 않고 가구 치수로만 판단하기로 했습니다.
- 80cm 떨어진 두 상자를 넣었더니 한 방법은 0을, 다른 방법은 79를 내놓았습니다. 문제 세 개를 찾아 고쳤습니다.
- 인수 테스트(요구 사항대로 동작하는지 보는 테스트) 26개를 쓰고, 처음 실패한 7개를 코드 문제와 테스트 문제로 나눠 고쳤습니다.
- 두 방법을 무작위 배치에 같이 돌려 "2000개 배치, 3939개 경로에서 99.72%가 ±1cm 안"이라고 보고했습니다. [직접 측정]
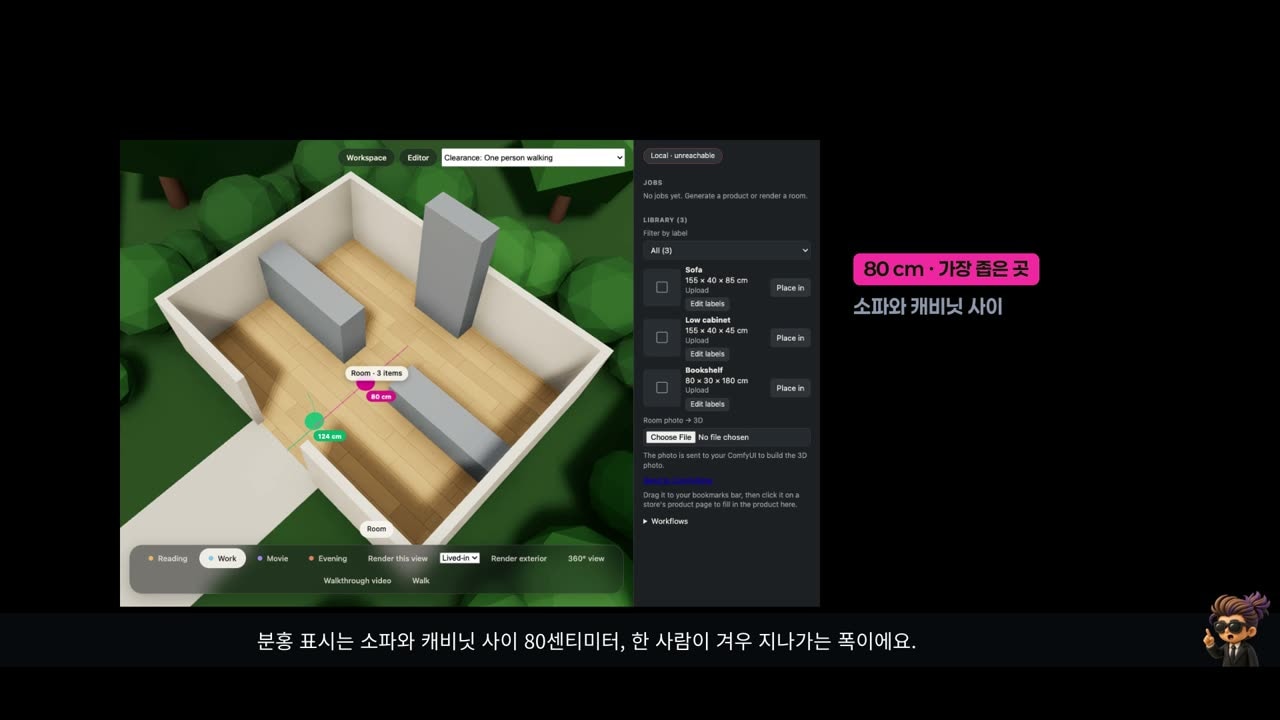
완성된 화면에서는 경로마다 가장 좁은 곳에 표시가 찍힙니다. 분홍 표시는 소파와 캐비닛 사이 80cm, 초록 표시는 문 앞 124cm입니다. 사기 전에 어디가 좁아지는지 한눈에 보입니다.
여기까지만 보면 끝난 것 같습니다. 그런데 이 숫자에는 문제가 있었습니다.
4. 바깥 심판: 2000개라던 검증이 381개였다
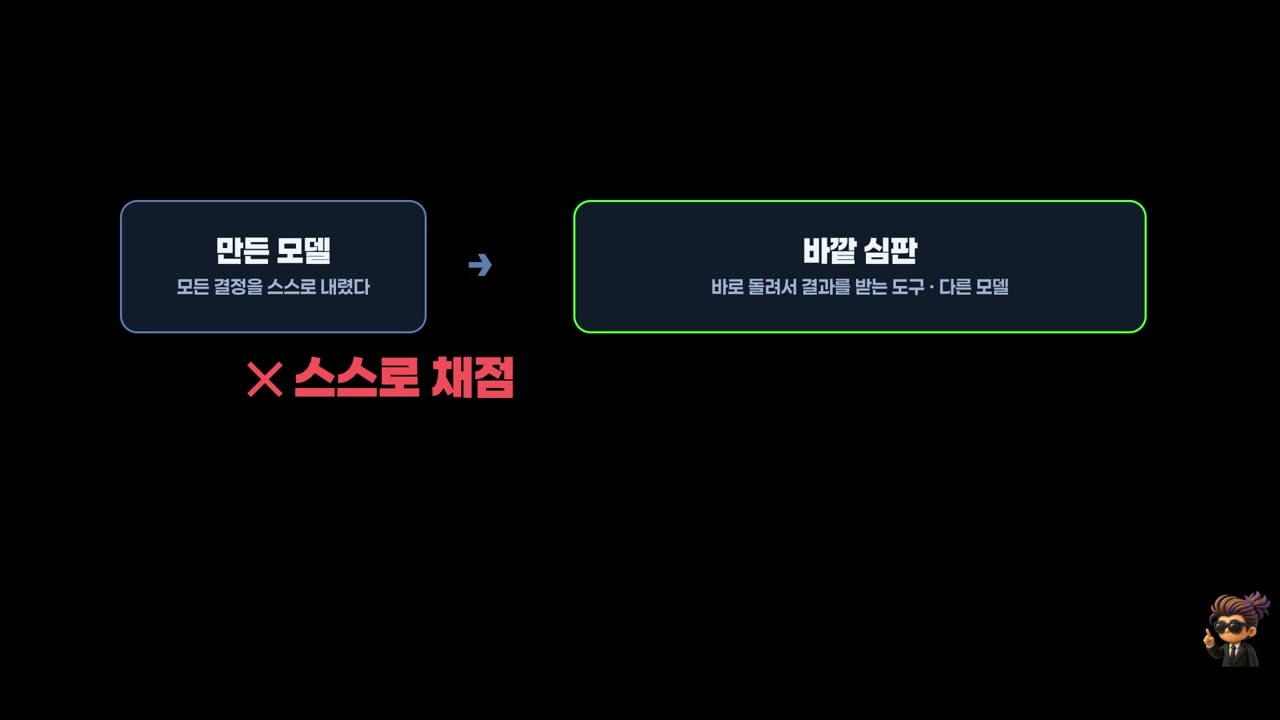
펠릭스는 모델에게 자기 일을 채점하게 하지 말라고 합니다. 바로 돌려서 결과를 받을 수 있는 도구가 가장 좋습니다 [공식 문서]. 그 일의 결정을 모두 그 모델이 내렸으니까요.
그래서 Claude에게 Codex CLI로 검토받고, 지적은 근거를 확인해서 맞는 것만 고치라고 했습니다. Codex는 읽기 전용이라 코드를 바꾸지 못합니다. [직접 측정]
- Codex가 지적 7개를 냈습니다. Claude는 바로 고치지 않고 6개는 직접 재현했고, 1개는 코드로 확인했습니다.
- 고치다 보니 더 큰 문제가 드러났습니다. 무작위 배치 생성기가 숫자 정밀도 문제로 약 381개 주기로 같은 방을 반복하고 있었습니다. 앞의 "2000개 중 99.72%"는 사실 381개로 잰 숫자였습니다.
- 테스트 273개가 다 통과했는데 종료 코드만 실패인 것도 찾았습니다. 전에는 종료 코드를 확인하지 않아 놓쳤던 것입니다. 원인은 자기가 만든 테스트가 90초 동안 이벤트 루프를 막은 것이었습니다.
| 심판 전 보고 | 심판 뒤 다시 잰 값 | |
|---|---|---|
| 서로 다른 배치 수 | 2000개라고 보고(실제 약 381개) | 2000개 |
| ±1cm 안 경로 | 99.72% | 99.90% (경로 4042개) |
| 가장 크게 어긋난 값 | 1.3cm | 1.7cm |
| 테스트 | 통과 보고, 실제 종료 코드는 실패 | 273개 통과, 종료 코드 0 |
[직접 측정] 비율은 조금 올랐지만, 진짜 차이는 숫자 크기가 아니라 숫자를 믿어도 되느냐입니다. 그리고 최악 값은 오히려 커졌습니다. Claude는 자기 테스트의 허용치를 측정값에 맞춰 ±2cm로 고쳤다고 그대로 보고했습니다. 만든 모델 혼자였다면 381개짜리 검증을 2000개라고 믿고 넘어갔을 겁니다.
5. 범위: 명사를 동사로 바꾸기
펠릭스는 하이스트 영화를 예로 듭니다. 금고를 털기 전에 처음 30분 동안 재주가 다른 사람들을 모으는 그 장면입니다. 주의할 건 역할극입니다. 누구처럼 말해 달라고 하면 대화만 이상해지니, 그 사람이 실제로 하는 일을 시키라고 합니다 [공식 문서].
어떤 분야를 데려올지 찾는 요령은 명사를 동사로 바꾸는 것입니다. 분기 보고서는 발표 자료가 아니라, 바쁜 사람들이 원인과 결과를 믿고 30분 안에 결정하게 하는 일입니다.
ComfySims도 이렇게 말해 줬습니다. 3D 집 편집기가 아니라, 사려는 가구가 우리 집에 맞고 지낼 만한지 사기 전에 믿고 결정하게 하는 일이라고요. 그리고 분야마다 서브에이전트(작은 일을 따로 맡는 에이전트)를 띄워 차례로 고치게 했습니다.
Claude는 분야 7개를 골랐고, 그 사람처럼 말하지 말고 반품 분류표나 실측표처럼 그 사람이 실제로 만드는 결과물을 내라는 규칙을 정했습니다. 시간이 오래 걸려 네 번째 분야까지만 돌렸습니다. [직접 측정]
| 분야 | 찾은 것 | 고친 것 |
|---|---|---|
| 반품 사유 분석가 | 이미 가진 가구와 높이가 안 맞는 경우를 놓침 | 식탁 의자 팔걸이가 테이블 밑에 2cm 걸리면 빨갛게 표시 |
| 치수 검사원 | 깊이를 인치로 적은 소파(35)가 경고 없이 통과 | 88.9cm로 고치는 버튼 |
| 배송·설치 기사 | 도면상 90cm 침실 문의 실제 통과 폭이 72.5cm | 자세별 통과 계산, 반입 경로 실측표 |
| 인테리어 공간 계획가 | 주방 카운터가 문을 막는데 문제 없음으로 표시, 창 가림은 검사 안 함 | 문 앞 가림·문 열림·창 가림 검사 |
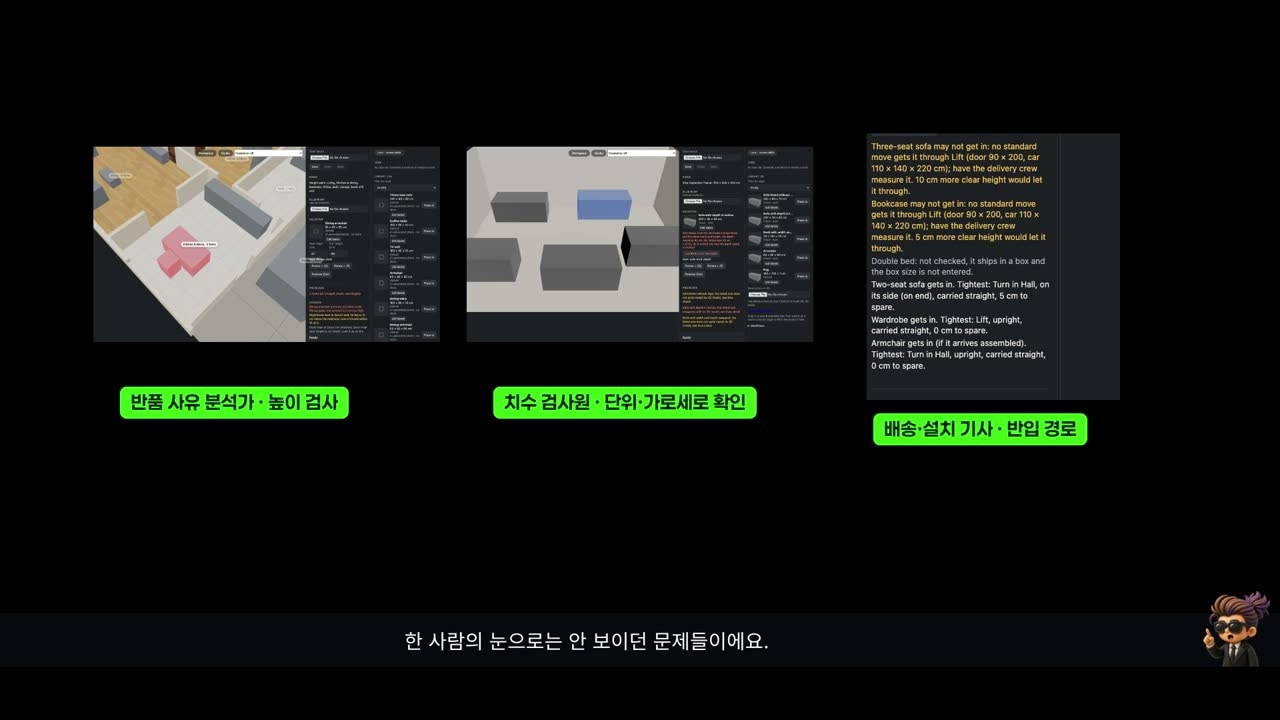
테스트는 네 번째 분야까지 329개로 늘었고, 매번 전체 검사를 다시 통과했습니다. 분야마다 다른 눈으로 보니까 앞에서 못 보던 문제가 하나씩 드러났습니다.
6. Claude에게 줘야 할 것
펠릭스는 이 모든 방법이 통하려면 모델에게 소프트웨어를 설치할 수 있는 컴퓨터와 관련 데이터가 있어야 한다고 합니다. MCP 커넥터든 다른 방법이든 상관없습니다 [공식 문서]. 앱이 멈추지 않게 맡기기 전에 그가 먼저 한 일은 세 가지입니다.
- 크래시 보고서를 쉽게 가져올 수 있게 했습니다.
- 어느 앱 버전이 어느 커밋인지 알 수 있게 했습니다.
- 윈도·맥·리눅스 컴퓨터를 줘서 직접 재현하고 고친 걸 확인하게 했습니다.
이번 프로젝트에도 같은 세 가지가 있었습니다. [직접 측정]
| 필요한 것 | ComfySims에 있던 것 |
|---|---|
| 볼 수 있게 | 화면을 찍어 보는 도구. 시키지 않아도 Claude가 먼저 찍어 봤습니다 |
| 알 수 있게 | 스펙, 결정 기록, 저장소 규칙 |
| 확인할 수 있게 | 테스트, 가짜 Comfy Cloud, 검사를 통과해야 끝나는 하네스 |
확인할 방법이 없는데 더 좋은 결과를 요구해 봐야 소용없습니다. 작게 시작한다면, 다음 프롬프트에 목표 한 줄부터 붙여 보시면 좋겠습니다.
이번 실습의 한계
- 프로젝트 하나에서 방법마다 한 번씩만 돌렸습니다. 고도 비교도 패널 하나의 결과입니다. 어떤 방법이 몇 퍼센트 낫다고 잰 것이 아닙니다.
- 코드를 일부러 틀리게 바꿔 테스트가 잡는지 보는 변이 테스트는 끝내지 못했습니다. 변이 2442개 중 15%(446개)에서 54분이 걸렸고 그때 점수는 75.3%였는데, Codex 지적을 고치기 전 코드로 돈 결과라 최종 증거가 아닙니다.
deep-prompt.md에 적은 증거 중 실제 방을 줄자로 재는 비교는 하지 않았습니다.- 범위는 7개 분야 중 4개만 돌렸습니다. 출처를 못 찾은 기준 4개(높이 2개, 치수 5%, 창 앞 50cm)는 스펙에 미확인으로 표시하고 경고만 냅니다.
- 펠릭스의 글은 경험에서 나온 조언이고, 효과를 실험으로 잰 자료는 아닙니다.
영상으로 보기
같은 과정을 실제 실행 화면과 함께 영상으로 정리했습니다.
출처
- Felix Rieseberg, How to be more ambitious: A tutorial for humans with models (2026-10-13)
- Locke & Latham, Building a practically useful theory of goal setting and task motivation: A 35-year odyssey, American Psychologist (2002)
- dante01yoon/claude-ambition-practice: 영상 속 프롬프트 원문(PROMPTS.md)
- dante01yoon/ComfySims: 시연 프로젝트