
2024년 여름, AI에게 "strawberry에 r이 몇 개야?"라고 물으면 "두 개"라고 답하곤 했습니다. 정답은 세 개입니다. 코드도 짜고 시험도 통과하는 AI가 글자 세 개를 못 센 겁니다.
그때 많이 나온 설명이 토큰입니다. AI는 글을 글자로 읽지 않고, 글을 자른 조각의 번호로 읽는다는 것이죠. 이 글에서는 그 조각을 직접 잘라 보고, 요즘 모델은 어떤지 직접 물어봤습니다.
이 글에서는 다음을 차례로 봅니다.
- 예전 AI는 정말 r을 못 셌나
- 토큰과 토크나이저는 무엇인가
- strawberry, 딸기, 숫자를 직접 잘라 보기
- 토큰은 요금의 단위이기도 하다
- 요즘 모델 다섯 개에게 322번 물어본 결과
- 요즘 모델이 맞히는 이유 세 가지
숫자 읽는 법. [공식 문서] 는 앤트로픽·OpenAI가 직접 낸 자료, [논문] 은 공개 논문, [직접 측정] 은 저희가 직접 돌려 잰 숫자, [커뮤니티 보고] 는 사용자 글이나 기사에 나온 사례입니다.
1. 예전 AI는 정말 r을 못 셌나
네, 기록이 남아 있습니다.
- 2024년 6월, OpenAI 커뮤니티에 "ChatGPT가 strawberry의 r을 2개라고 한다"는 글이 올라왔습니다. 다시 물어도 같은 답이었고, 답글에서는 GPT-4와 GPT-4o 둘 다 틀린다고 했습니다. [커뮤니티 보고] (OpenAI 커뮤니티)
- 2024년 8월, 한 개발자가 GPT-4o로 재현했습니다. 그냥 물으면 2개, 파이썬으로 세게 하면 3개였습니다. [커뮤니티 보고] (legoktm 블로그)
- 2024년 8월 27일 TechCrunch는 GPT-4o와 클로드가 둘 다 "2개"라고 답했다고 보도했습니다. 기사 속 전문가 설명은 "모델은 단어를 덩어리로 보고 글자를 모른다"였습니다. [커뮤니티 보고] (TechCrunch)
2. 토큰과 토크나이저
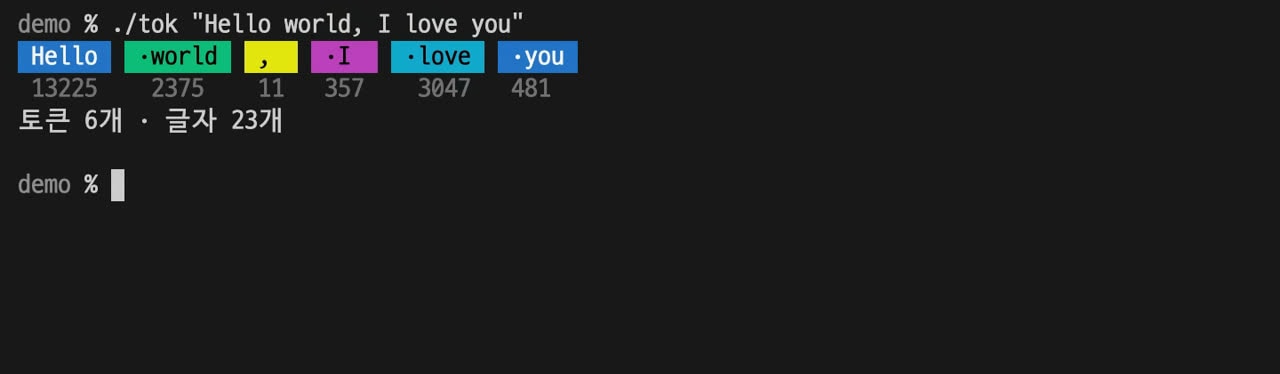
모델은 글을 읽기 전에 먼저 글을 작은 조각으로 자릅니다. 자르는 프로그램을 토크나이저(tokenizer), 잘린 조각 하나하나를 토큰(token) 이라고 부릅니다. 토큰은 단어 하나일 때도 있고, 단어의 일부일 때도 있습니다.
GPT-4o가 쓰는 토크나이저(OpenAI가 공개한 tiktoken의 o200k_base)에 "Hello world, I love you"를 넣어 봤습니다. [직접 측정]
- 흔한 단어는 통째로 한 조각입니다. Hello, world, love가 하나씩입니다.
- world 앞의 점은 띄어쓰기입니다. 띄어쓰기도 뒤 단어에 붙어서 같이 들어갑니다.
- 조각마다 아래에 번호가 있습니다. 모델이 실제로 받는 건 이 번호들입니다.
자주 안 쓰는 단어는 여러 조각으로 잘립니다. unbelievable을 띄어쓰기 없이 넣으면 un, bel, ievable 세 조각입니다. 그런데 문장 속처럼 앞에 띄어쓰기가 있으면 한 조각이 됩니다. 같은 단어도 어디에 놓이느냐에 따라 잘리는 모양이 달라집니다. [직접 측정]
이 토크나이저가 아는 조각은 모두 20만 개 정도입니다 [공식 문서] (tiktoken). 모델 입장에서는 이 조각 목록이 알파벳 전부인 셈입니다. 모델은 번호 목록을 받고, 답도 번호를 하나씩 내놓습니다. 그 번호를 다시 글자로 바꿔서 우리가 보는 겁니다.
3. strawberry, 딸기, 숫자를 잘라 보기
strawberry
 [직접 측정]
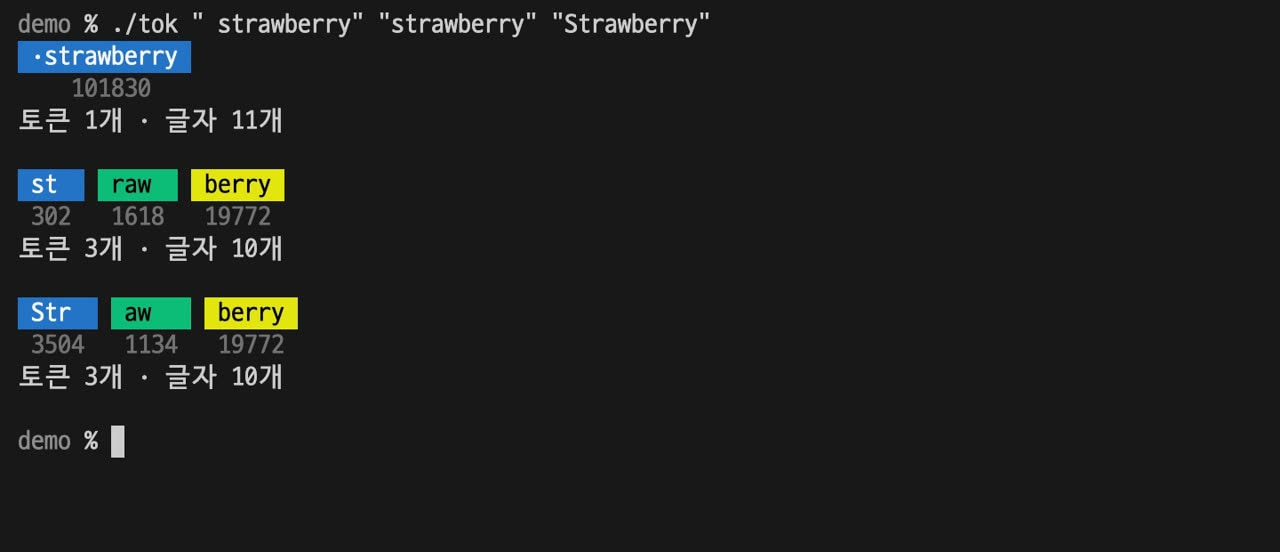
- 앞에 띄어쓰기가 있으면 strawberry는 조각 하나, 번호 하나(101830)입니다.
- 띄어쓰기 없이 쓰면 st, raw, berry 세 조각입니다.
- 첫 글자를 대문자로 바꾸면 Str, aw, berry로 또 다르게 잘립니다.
글자는 같은데 모델이 받는 번호는 완전히 달라집니다. 그러니까 "r이 몇 개냐"는 질문은, 이 조각을 보여 주고 r을 세라는 것과 비슷합니다. 조각 안의 글자는 입력에 들어 있지 않습니다. 모델은 학습 때 읽은 글에서 이 단어의 철자를 떠올려야 하고, 그 기억이 틀리면 "두 개"가 나옵니다.
다만 원인은 연구자들 사이에서도 의견이 갈립니다.
- 토큰이 근본 병목이라는 연구가 있습니다. 글자 단위 과제 19개로 시험하고 글자를 인식하는 모듈을 따로 제안했습니다. [논문] (The Strawberry Problem, arXiv 2505.14172)
- 토큰이 쪼개진 모양과 정답 여부의 관계는 약하고, 단어 길이와 실제 글자 수가 더 크게 작용한다는 연구도 있습니다. 여러 모델의 평균 정답률은 43.6%였습니다. [논문] (CharBench, arXiv 2508.02591)
- 글자 단위로 쪼개서 넣어 줘도 크게 좋아지지 않았고, 답하기 전에 명시적으로 추론하게 하는 것이 가장 확실했다는 연구도 있습니다. [논문] (The Genius Paradox, arXiv 2410.14166)
정리하면, "토큰 때문에 글자가 입력에 바로 보이지 않는다"는 토크나이저로 확인할 수 있는 사실입니다. "그래서 틀린다"는 아직 갈리는 설명입니다.
한국어 "딸기"
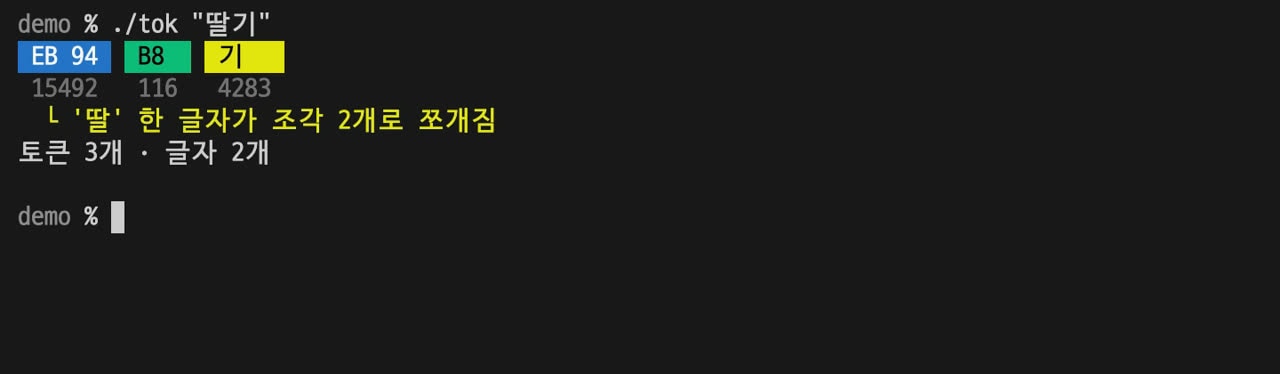
"딸기"를 넣으면 '기'는 한 조각인데, '딸'은 바이트 조각 두 개로 쪼개집니다. [직접 측정] 바이트(byte) 는 컴퓨터가 글자를 저장하는 가장 작은 단위입니다. 한글 한 글자는 바이트 세 개로 저장되는데, 그게 중간에서 잘려 두 조각이 된 겁니다. 그래서 "딸기에 ㄹ이 몇 개냐"는 strawberry보다 더 어려운 질문이 됩니다.
숫자
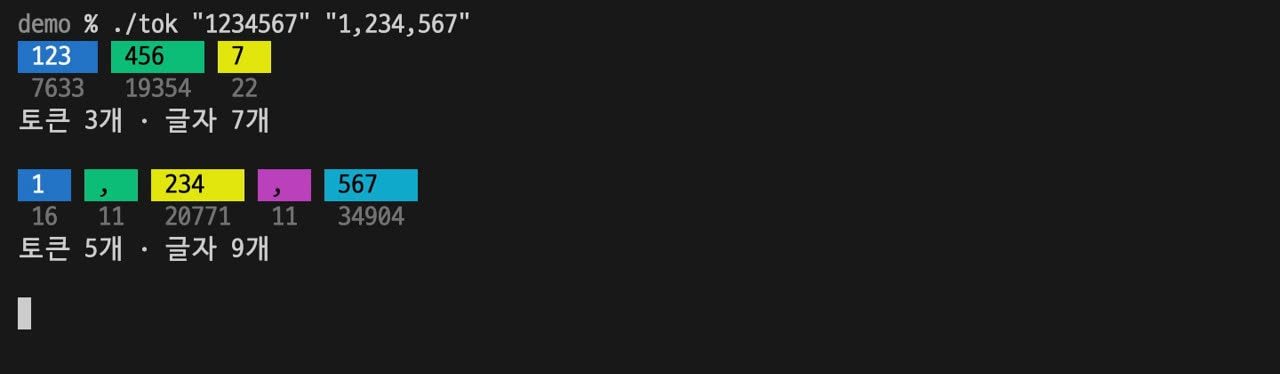
숫자도 잘립니다. 1234567은 123, 456, 7 세 조각입니다. 쉼표를 넣으면 1, 쉼표, 234, 쉼표, 567 다섯 조각이 됩니다. [직접 측정] 덩어리 크기가 제각각이면 자릿수를 맞춰 더하기가 어렵습니다. 예전 모델이 긴 덧셈을 자주 틀린 이유 중 하나로 꼽히는 부분입니다. 이번에 열 자리 덧셈도 시켜 봤는데, 요즘 모델은 전부 정답이었습니다. [직접 측정]
4. 토큰은 요금의 단위
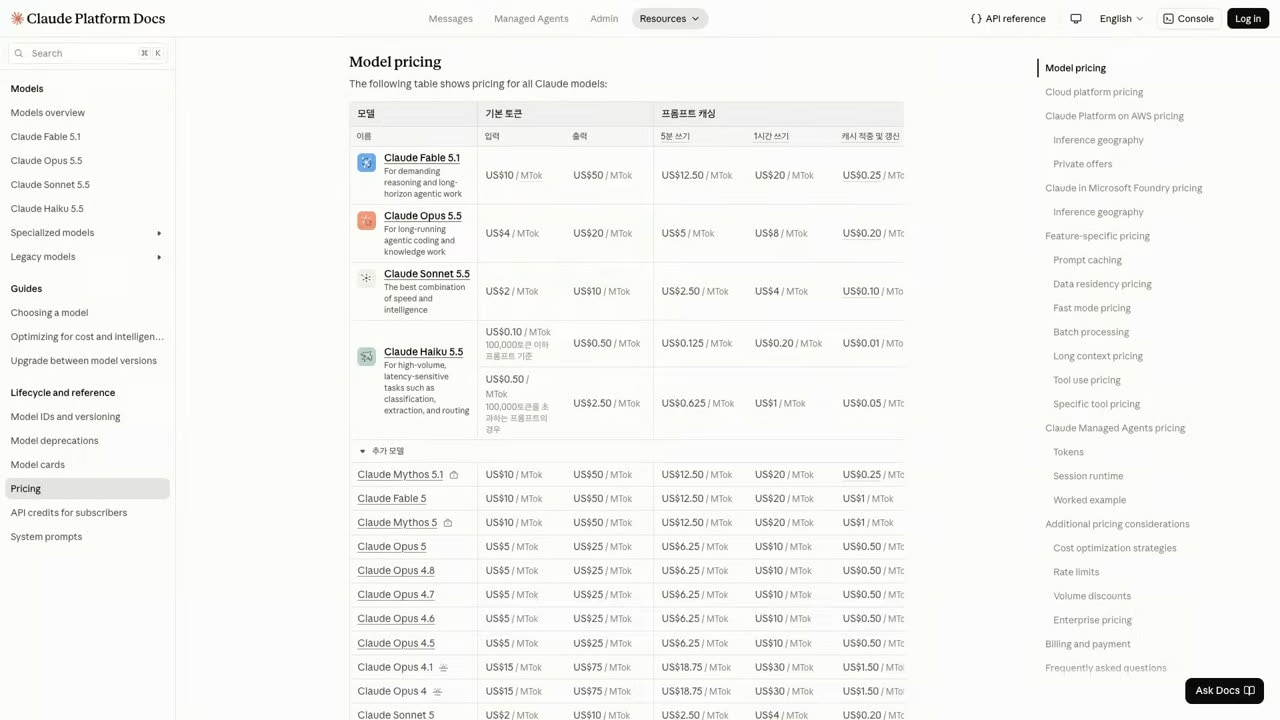
개발자가 프로그램으로 모델을 쓸 때(API) 보는 가격표는 전부 "100만 토큰당 얼마"로 적혀 있습니다. 클로드 오퍼스 5.5는 입력 100만 토큰에 4달러, 출력은 20달러입니다. [공식 문서] (Anthropic 가격 안내)
코딩 에이전트는 여기서 토큰을 많이 씁니다. 한 번 주고받을 때마다 지금까지의 대화를 처음부터 다시 보내기 때문입니다. 내 요청, 읽은 파일, 메모, 도구 결과까지 매번 다시 토큰으로 계산됩니다. 프롬프트 캐시로 할인은 되지만, 쌓이는 양은 그대로입니다.
언어마다 다른 토큰 수
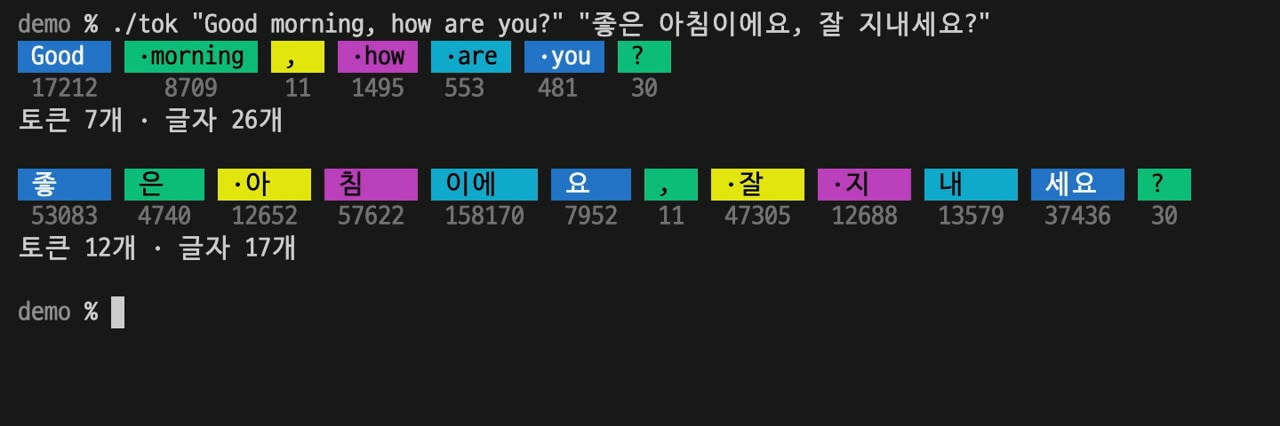
같은 인사를 영어("Good morning, how are you?")로 쓰면 토큰 7개, 한국어("좋은 아침이에요, 잘 지내세요?")로 쓰면 12개입니다. 같은 뜻인데 토큰이 1.7배쯤 많습니다. 다만 흔한 문장은 차이가 작아서, 다른 예문은 영어 6개, 한국어 7개였습니다. [직접 측정] 토크나이저가 어떤 글을 많이 보고 만들어졌느냐에 따라 조각 크기가 달라지기 때문입니다.
앤트로픽 가격 안내에도 같은 글이 몇 토큰이 되는지는 토크나이저, 언어, 내용에 따라 다르다고 적혀 있습니다. 또 Claude 4.7 이후 모델은 새 토크나이저를 써서 같은 글이 약 30% 더 많은 토큰이 된다고 합니다. [공식 문서] (Anthropic 가격 안내)
5. 요즘 모델에게 322번 물어보기
시험 방법
[직접 측정] (2026년 10월 31일)
- 모델 5개: Claude Haiku 5.5, Sonnet 5.5, Opus 5.5(Claude Code에서 도구 끄고 실행), GPT-6.1 Terra, GPT-6.1 Sol(Codex CLI에서 명령 실행 금지, 실제 도구 호출 0회 확인). Sol은 가장 낮은 추론 강도(low)로 돌렸습니다.
- 문항 17개: strawberry·raspberry·cranberry·Mississippi의 글자 세기, 일부러 바꾼 단어(strawberrrry는 r 5개, 철자 틀린 strawbery는 r 2개), 무작위 문자열(10자·40자), 문장 속 e 세기, 긴 단어의 글자 수, 한글 자모 세기(딸기의 ㄹ, 안녕하세요의 ㅇ 등), 열 자리 덧셈.
- 질문 끝에 "숫자만 답해"를 붙였습니다.
- 생각했는지 보는 법: GPT는 응답에 추론 토큰 수가 따로 찍힙니다. 클로드는 생각을 끄는 설정을 줘도 꺼지지 않아서, 출력 토큰 수로 봤습니다. 3개면 바로 답한 것이고, 수십~수백 개면 속으로 생각한 것입니다.
결과
| 모델 | 실행 수 | 틀림 | 틀린 문항 |
|---|---|---|---|
| Claude Haiku 5.5 | 126 | 5 | 철자 틀린 strawbery(정답 2)를 3이라고 4회, strawberrrry(정답 5)를 3이라고 1회 |
| Claude Sonnet 5.5 | 51 | 0 | — |
| Claude Opus 5.5 | 71 | 0 | — |
| GPT-6.1 Terra | 40 | 7 | 딸기의 ㄹ(정답 1)을 2라고 6회, 주소의 ㅇ(정답 4)을 3이라고 1회 |
| GPT-6.1 Sol | 34 | 0 | — |
원래 문제인 "strawberry의 r"은 다섯 모델 모두, 모든 회차 정답(19회)이었습니다. 총 322회 중 오답은 12회입니다.
생각 토큰 0과 22의 차이
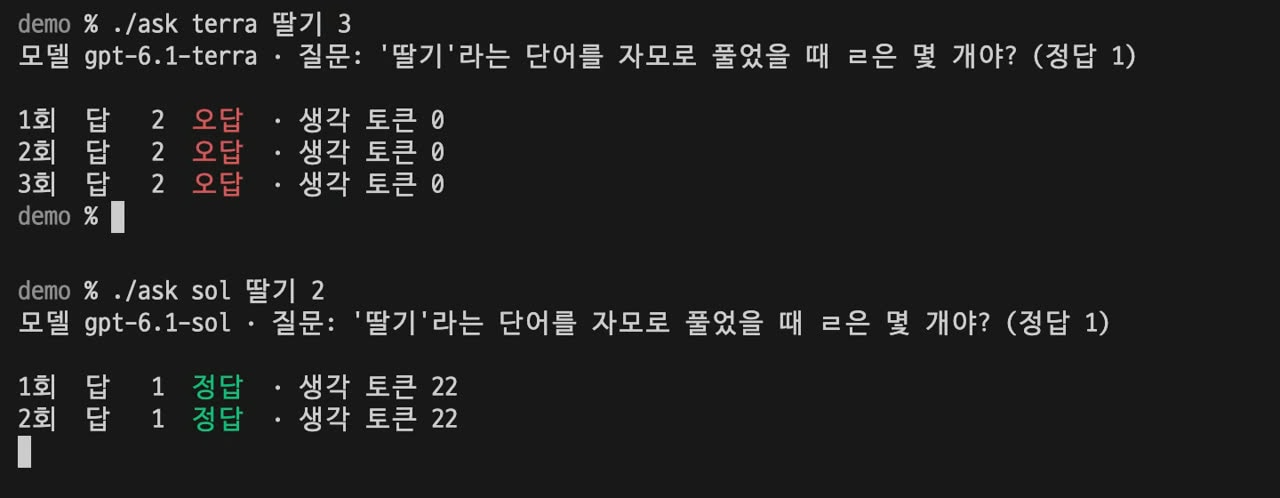
영상 녹화 중에 GPT-6.1 Terra에게 "딸기의 ㄹ이 몇 개냐"를 동시에 세 번 물었습니다. 정답은 1개인데 세 번 다 2개라고 답했고, 생각 토큰은 전부 0이었습니다. 생각 토큰은 모델이 답하기 전에 속으로 쓰는 토큰입니다. 0이면 생각 없이 바로 답했다는 뜻입니다.
같은 질문을 GPT-6.1 Sol에게 했더니 두 번 다 1개, 정답이었습니다. 생각 토큰을 22개씩 썼습니다. [직접 측정]
녹화 전후 실행까지 합치면 Terra가 생각 토큰 0으로 답한 14번은 모두 2개였고, 생각 토큰 21개를 쓴 2번은 1개(정답)였습니다. [직접 측정]
외운 답의 함정
그런데 Terra도 strawberry는 생각 토큰 0으로 바로 정답을 냅니다. 외운 답에 가깝다고 봅니다. 2024년에 이 질문이 워낙 유명해져서 정답이 학습 자료에 많이 들어갔을 것이라는 추정입니다.
외운 답이 오히려 함정이 되기도 합니다. Claude Haiku 5.5에게 철자를 틀린 strawbery를 물었더니, r이 두 개인데도 세 개라고 답했습니다. 여덟 번 중 네 번입니다. 토큰 수가 기록된 오답 2회는 모두 출력 3토큰, 즉 바로 답한 경우였고, 56토큰을 쓰고 생각한 회차는 2개로 맞혔습니다. 유명한 정답 쪽으로 끌려간 것입니다. [직접 측정]
6. 요즘 모델이 맞히는 이유 세 가지
- 답하기 전에 속으로 풀어 써 봅니다. Sol은 가장 낮은 설정에서도 추론했고, 클로드도 "숫자만 답해"라고 해도 속으로 수백 토큰을 썼습니다. 틀린 경우는 거의 다 생각 토큰이 0이거나 3토큰으로 바로 답할 때였습니다. 앞의 연구(The Genius Paradox)도 "답하기 전에 추론"을 가장 확실한 해결로 꼽습니다.
- 유명한 질문은 답을 외웠습니다. strawberry처럼요. 대신 그 기억이 철자를 살짝 바꾼 질문에서는 독이 됩니다.
- 토크나이저는 그대로입니다. strawberry는 여전히 조각으로 들어가고, '딸'은 바이트 조각 두 개로 쪼개집니다. 그래서 생각 없이 바로 답하면 아직 틀릴 수 있습니다. 약점이 고쳐진 게 아니라, 추론으로 돌아서 가는 것입니다.
한 줄로 줄이면 이렇습니다. 모델은 글자를 읽지 않습니다. 글을 자른 조각의 번호를 읽습니다. 이걸 알고 나면 AI의 이상한 실수도, 요금도 훨씬 이해가 쉬워집니다.
이번 시험의 한계
- 표본이 작습니다. 조건마다 2~6회씩 물었습니다. 그래서 비율보다 "몇 번 중 몇 번"으로 적었습니다.
- 모델 회사들은 내부 동작을 공개하지 않습니다. "생각하면 맞고 바로 답하면 틀렸다"는 이번 실측에서 본 관찰이고, "정답이 학습 자료에 들어갔다"는 추정입니다.
- 토큰을 잘라 본 화면은 GPT-4o 토크나이저(
o200k_base) 기준입니다. 클로드나 최신 GPT 모델의 토크나이저는 조각 모양이 다를 수 있습니다. - 모든 실행은 구독 앱(Claude Code, Codex CLI)에서 했고, API 설정과는 조건이 다를 수 있습니다.
영상으로 보기
같은 내용을 실제 실행 화면과 함께 영상으로 정리했습니다.
출처
- OpenAI, tiktoken —
o200k_base(GPT-4o 토크나이저) - Anthropic, Pricing (2026-11 확인)
- TechCrunch, Why AI can't spell 'strawberry' (2024-08-27)
- OpenAI Developer Community, Incorrect count of 'r' characters in the word "strawberry" (2024-06)
- legoktm, How many Rs are in the word strawberry? (2024-08-10)
- Cosma et al., The Strawberry Problem: Emergence of Character-level Understanding in Tokenized Language Models (2025)
- Uzan & Pinter, CharBench (AAAI-26)
- Xu & Ma, The Genius Paradox (NAACL 2025)