
AI에게 자기가 방금 짠 계획을 검토해 달라고 하면 좋은 계획이라는 답이 나오기 쉽습니다. 왜 그렇게 짰는지 이미 다 알고 있어서, 계획서에 빠진 설명이 있어도 머릿속으로 채워 읽기 때문입니다.
EGM(Elephant-Goldfish Model, 코끼리·금붕어 모델)은 이 문제를 단순하게 풉니다. 검토하는 AI에게 대화를 보여 주지 않습니다. 정말 효과가 있는지 보려고, 같은 기능을 EGM과 Claude Code 플랜 모드로 각각 만들어 비교했습니다.
이 글에서는 다음을 차례로 봅니다.
- EGM이 무엇이고 왜 기억을 지우나
- 플랜 모드와 무엇이 다른가
- 실험을 어떻게 했나
- EGM을 처음부터 끝까지 쓰면 일어나는 일
- 금붕어 둘이 같은 말을 해서 설계를 덜어낸 장면
- 결과: 시험은 비겼고, 비용은 28배
- 차이는 아무도 안 물어본 질문 하나
- 언제 쓰고 언제 쓰지 말까
- 이번 실험의 한계
숫자 읽는 법. [공식 문서] 는 EGM 저장소와 Claude Code 문서처럼 만든 쪽이 직접 쓴 자료, [직접 측정] 은 저희가 이번에 직접 돌려 본 결과입니다. 측정은 모두 같은 모델(Claude Sonnet 5.5, 생각하는 양 xhigh)로 방식마다 한 번씩만 했습니다. "이번에 이랬다"로 읽어 주세요.
1. EGM이 무엇이고 왜 기억을 지우나
EGM은 2026년 9월에 google/elephant-goldfish-model 저장소로 공개된 오픈소스 플러그인입니다. 저장소 첫머리의 설명은 "Design with an elephant. Review with a goldfish."입니다. 코끼리와 설계하고, 금붕어와 검토하라는 뜻입니다. 다만 구글 저장소에 있어도 README 끝에는 구글이 공식 지원하는 제품이 아니라고 적혀 있습니다 [공식 문서] (저장소).
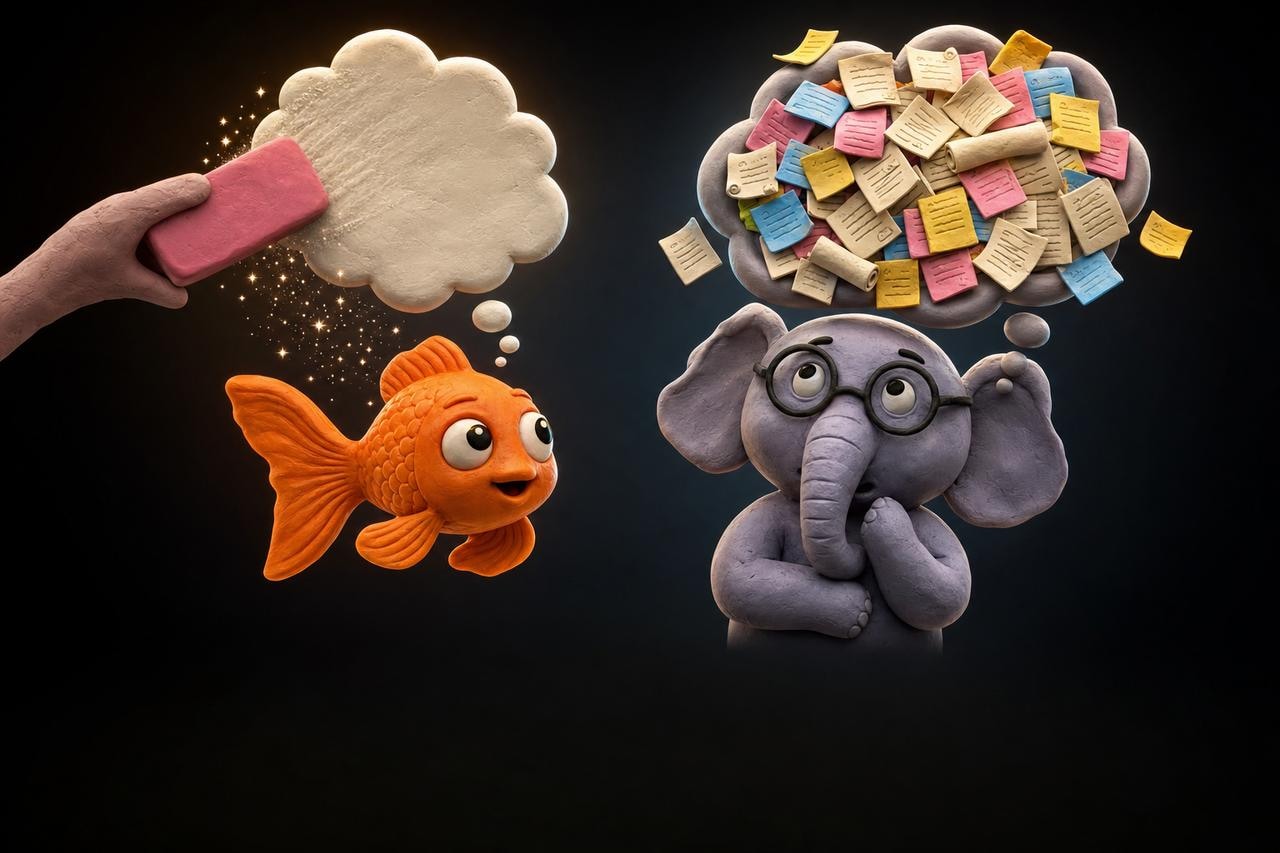
역할은 셋입니다 [공식 문서].
| 역할 | 보는 것 | 하는 일 |
|---|---|---|
| 코끼리 | 프로젝트와 지금까지의 대화 전부 | 질문하고 설계서를 씁니다 |
| 금붕어 | 설계서와 참고할 코드만 | 숨은 가정과 빈틈을 찾습니다 |
| 나 | 목표와 제약 | 지적 중 무엇을 받을지 고르고 승인합니다 |
금붕어는 Claude Code의 서브에이전트로 만듭니다. 서브에이전트는 메인 AI가 일을 맡기려고 따로 띄우는 또 다른 AI로, 자기만의 빈 대화에서 시작하고 결과만 돌려줍니다 [공식 문서] (서브에이전트 문서). 앞 대화를 모르니 설득당할 수도 없고, 글에 안 적힌 가정은 그대로 걸립니다. 사람도 자기가 쓴 글의 오타는 잘 못 보는 것과 비슷합니다.
코드보다 설계서를 먼저 쓰고 그 설계서로 코드를 만드는 방식을 스펙 주도 개발(Spec-Driven Development)이라고 합니다. EGM은 그 방식 중 하나입니다.
2. 플랜 모드와 무엇이 다른가
플랜 모드는 Claude Code에 원래 있는 기능입니다. 파일을 고치기 전에 코드를 읽고 계획을 보여 주고, 사람이 승인하면 구현합니다 [공식 문서] (권한 모드 문서).
| 플랜 모드 | EGM | |
|---|---|---|
| 순서 | 요청 → 계획 → 승인 → 구현 | 질문 → 금붕어 6마리 → 섹션별 초안 → 금붕어 5단계 → 구현 → 문서와 코드 대조 |
| 계획 검토 | 같은 대화 안에서 사람이 | 대화를 못 본 AI 여럿이 여러 번 |
| 장점 | 빠르고 쌉니다 | 코드 전에 빈틈을 더 찾습니다 |
| 약점 | 물어보지 않은 건 AI가 대신 정할 수 있습니다 | 느리고 비쌉니다 |
3. 실험을 어떻게 했나
약 760줄짜리 작은 원데이 수업 예약 앱을 준비했습니다. 수업 목록, 예약, 내 예약, 취소까지 되는 앱입니다. 여기에 넣을 기능을 한 문장으로 정했습니다.
자리가 다 찬 수업에 대기 신청할 수 있게 하고, 누가 취소하면 대기 1번한테 자동으로 자리 넘겨줘
이 문장을 두 방식에 한 글자도 다르지 않게 넣었습니다. 측정은 두 번으로 나눠서 합니다. [직접 측정]
- 미리 해 본 실험: 결과를 보기 전에 시험을 먼저 정했습니다. 두 방식의 폴더 밖에 숨은 테스트 28개를 뒀고, 어느 쪽 대화 기록에도 이 테스트가 나타나지 않는 것을 확인했습니다. 시간과 비용도 쟀습니다. 이 글의 시험·비용 숫자는 모두 이쪽입니다.
- 녹화한 실행: 영상에 담으려고 같은 요청을 처음부터 다시 돌렸습니다. 4절과 5절의 장면과 숫자는 주로 이쪽입니다. 비용은 재지 않았습니다.
나눠 읽는 이유가 있습니다. 같은 모델로 같은 요청을 줘도 결과가 달랐기 때문입니다. 7절에서 다시 다룹니다.
4. EGM을 처음부터 끝까지 쓰면 일어나는 일
설치
README에 적힌 두 줄입니다 [공식 문서].
claude plugin marketplace add google/elephant-goldfish-model
claude plugin install egm@egm
부트스트랩: 금붕어가 읽을 안내문 깔기
/egm:egm-bootstrap .을 실행합니다. 금붕어는 대화를 못 보니, 코드만 보고도 폴더의 역할을 알 수 있어야 합니다. 그래서 폴더마다 README를 씁니다. 이 폴더가 무슨 일을 하고, 밖에 무엇을 내놓고, 무엇을 꼭 지켜야 하는지 적은 계약서 같은 문서입니다. 이번에는 서브에이전트 넷이 나눠 맡아 README 7개가 생겼습니다. [직접 측정]
브레인스토밍: 코끼리의 질문, 금붕어 여섯 마리
/egm:egm-brainstorm 뒤에 앞의 요청을 붙였습니다. 플랜 모드라면 계획을 쓸 자리에서 코끼리는 코드를 읽고 질문 5개를 던졌습니다. 지금은 마감되면 어떻게 하는지, 대기자는 승격을 어떻게 아는지, 대기 인원 상한은 몇 명인지, 이미 쓰는 DB가 있는지 같은 질문입니다. 요청의 약점도 먼저 짚었습니다. 알릴 방법이 없다는 점입니다. [직접 측정]
답을 정리한 뒤에는 금붕어 여섯 마리가 동시에 뜹니다. 이해가 되는지, 구조가 맞는지, 설계가 좋은지, 더 쉬운 길은 없는지, 그대로 구현할 수 있는지, 실제 코드와 맞는지를 각자 봅니다. 결과는 concepts_brief.md 한 파일로 합쳐지고, 이 단계에 약 9분이 걸렸습니다. [직접 측정]
여기서 눈에 띄는 지적이 나왔습니다.
시작 후 대기 항목의 생명주기가 비어 있다. 서버에 정리 작업이 없어서, 수업이 시작된 뒤에도 대기 행이 남는다는 지적입니다. 여섯 렌즈가 모두 같은 문제를 짚었습니다. 저희가 물어본 적 없는 내용입니다. [직접 측정]
초안: 결정은 사람에게 넘긴다
/egm:egm-draft는 설계 문서를 섹션마다 멈춰 가며 씁니다. 기술 결정은 보기 몇 개와 각 보기가 실패하는 조건을 함께 보여 주고 사람에게 고르게 합니다. 녹화에서는 결정 4개를 직접 골랐습니다. 다음 절에 나올 "새치기 방지"도 그중 하나입니다. [직접 측정]
검토 5단계
/egm:egm-review는 금붕어들이 다섯 단계로 설계 문서를 봅니다. 단계 번호는 5부터 9까지입니다 [공식 문서] (검토 스킬).
| 단계 | 보는 것 |
|---|---|
| Stage 5 줌 아웃 | 더 쉬운 길은 없나 |
| Stage 6 이해도 | 처음 읽는 사람이 이해하나 |
| Stage 7 비평 | 설계, 구조, 문체 |
| Stage 8 중간 줌 아웃 | 범위가 커지지 않았나 |
| Stage 9 구현 준비 | 추측 없이 구현할 수 있나 |
녹화에서는 이 과정이 한 시간 넘게 걸렸고 중요한 지적만 서른 개가 넘었습니다. [직접 측정]
구현과 드리프트 리포트
구현은 대화를 비운 새 세션에서 설계 문서만 보고 했습니다. 약 8분이 걸렸고 테스트 59개가 통과했습니다. 마지막 /egm:egm-drift-report는 문서와 코드가 어긋난 곳을 찾습니다. 드리프트는 시간이 지나며 문서와 코드가 서로 달라지는 현상입니다. 코드가 설계와 다른 곳은 0개, 문서 쪽 어긋남은 7개였습니다. 설계 상태가 아직 "제안됨"으로 남아 있다거나, README가 새 호출 하나를 빠뜨렸다는 식입니다. [직접 측정]
5. 금붕어 둘이 같은 말을 해서 설계를 덜어낸 장면
초안 단계에서 저희는 새치기 방지를 골랐습니다. 대기자가 있는데 자리가 열려 있으면 새 예약을 거부하는 규칙입니다.
그런데 서로의 대화를 모르는 Stage 5와 Stage 7의 금붕어가 따로 같은 지적을 했습니다. 평소에는 취소가 나는 바로 그 순간 대기 1번이 자리를 받으니, 자리는 열렸는데 대기자가 있는 상태 자체가 생기지 않습니다. 그 상태는 운영자가 DB에 직접 명령을 넣어 정원을 늘릴 때만 생깁니다. 드문 경우 하나를 막으려고 규칙과 화면과 테스트를 늘린 셈입니다. [직접 측정]
그래서 저희 결정을 뒤집어 새치기 방지를 뺐습니다. 설계 문서에서는 "채택하지 않은 대안"으로 옮겨졌고, 막으려는 상태가 운영자 SQL로만 만들어지며 비용이 효과보다 크다는 이유도 함께 남았습니다. 미리 해 본 실험에서도 비슷한 장면이 나와, 규칙 3종과 약 90줄이 사라졌습니다. [직접 측정]
이번 실험에서 가장 좋았던 장면입니다. 검토가 기능을 늘린 게 아니라 줄였습니다.
6. 결과: 시험은 비겼고, 비용은 28배
미리 해 본 실험의 숫자입니다. [직접 측정] 비용은 Claude Code가 세션에 표시하는 누적 비용입니다.
| 플랜 모드 | EGM | |
|---|---|---|
| 숨은 테스트 | 28/28 | 28/28 |
| 걸린 시간 | 4분 50초 | 약 100분 |
| 비용 | $0.82 | $23.16 |
| 서브에이전트 | 0개 | 25개 |
| 추가한 소스 코드 | +261 / −19줄 | +286 / −33줄 |
| 전체 테스트 수 | 44개 | 73개 |
| 설계 문서 | 계획 파일 1개 | 1186줄 |
숨은 테스트는 대기 순서, 취소와 동시에 들어온 예약, 같은 예약 이중 취소, 20명 동시 예약, 옛 DB 이어받기처럼 까다로운 경우를 담았습니다. 시험 자체가 제대로 걸러 내는지도 확인했습니다. 승급을 일부러 "취소 뒤 잠깐 있다가" 하도록 비튼 구현은 실패합니다.
이 정도 크기의 앱에서 EGM이 테스트를 더 많이 통과하지는 않았습니다. 플랜 모드도 취소와 같은 트랜잭션(한 덩어리로 처리해 중간에 끼어들 수 없게 하는 묶음)에서 승급을 처리했고, 이미 예약한 대기자도 건너뛰었습니다.
EGM의 비용 $23.16은 대부분 코드 전에 쓰였습니다.
| 단계 | 시간 | 비용 |
|---|---|---|
| 부트스트랩 | 3분 54초 | $1.70 |
| 브레인스토밍 | 13분 32초 | $3.35 |
| 초안 | 15분 4초 | $2.72 |
| 검토와 지적 반영 | 59분 23초 | $13.31 |
| 구현 | 5분 | $1.20 |
| 드리프트 리포트 | 3분 14초 | $0.88 |
금붕어 지적은 모두 107건이었습니다(브레인스토밍 13, 검토 94). 검토 94건은 Major 30건, 사소한 지적인 Nit 64건이고 Blocker는 없었습니다. 코드를 짜는 값은 전체의 약 5%이고, 절반 이상은 검토와 반영에 들어갔습니다.
7. 차이는 아무도 안 물어본 질문 하나
미리 해 본 실험에서 플랜 모드는 질문 없이 가정 5개를 적고 구현했습니다. EGM은 수업이 시작된 뒤 대기 항목을 어떻게 보여 줄지 묻고 사람에게 결정하게 했습니다.
두 앱을 같은 데이터로 띄워, 18시 30분에 시작한 수업을 21시 40분대에 열어 봤습니다. [직접 측정]
- 플랜 모드 앱: 내 예약에 "대기 1번째예요. 자리가 나면 자동으로 예약돼요."가 그대로 남아 있습니다.
- EGM 앱: 그 줄이 없습니다.
결과를 본 뒤에 추가 시험 2개를 써 봤더니 플랜 모드 0/2, EGM 2/2였습니다. 하나는 이 시작 뒤 대기 표시이고, 다른 하나는 앞에서 나온 운영자 SQL 상황의 새치기입니다.
다만 이 숫자를 "EGM이 더 정확하다"로 읽으면 안 됩니다. EGM의 지적을 읽은 뒤에 쓴 시험이고, 플랜 모드는 그 질문을 받은 적이 없습니다. 공정한 사전 시험이 아니라 질문 단계의 효과를 보여 주는 관찰입니다.
녹화 때 다시 돌렸더니 결과가 또 달랐습니다. 이번 플랜 모드는 역시 질문 0개로 약 7분 만에 구현까지 끝냈고 테스트 48개가 통과했는데, 가정 목록에 "시작한 수업의 대기는 숨김"이 들어 있었습니다. 같은 모델도 할 때마다 다르다는 뜻입니다. 대신 "대기 인원 제한 없음"도 스스로 가정했습니다. 저희는 수업당 20명쯤을 생각하고 있었는데 말입니다. [직접 측정]
그러니 차이는 "플랜 모드가 놓친다"가 아닙니다. 플랜 모드에서는 맞든 틀리든 AI가 대신 정하고, EGM에서는 사람이 정합니다. 운이 좋으면 같은 답이 나오지만, 정했다는 사실을 사람이 모르고 지나갈 수 있습니다.
8. 언제 쓰고 언제 쓰지 말까
| EGM을 쓸 때 | 평소대로 할 때 |
|---|---|
| 결정할 게 많은 새 기능 | 작은 버그 하나 고치기 |
| 데이터가 날아가면 안 되는 변경 | 결정할 게 거의 없는 일 |
| 나중에 여러 사람이 읽을 설계 | 빨리 한 번 해 보는 실험 |
| 틀리면 비싼 변경 | 비용과 시간이 아까울 때 |
EGM 문서도 간단한 버그 수정에 이 절차를 억지로 쓰지 말고, 지금 막힌 곳에 맞는 스킬만 쓰라고 합니다 [공식 문서] (시작 안내). 전 과정을 돌릴 필요 없이 금붕어 검토만 쓰는 것도 가능합니다. README는 검토가 테스트나 사람의 판단을 대신하지 않는다고도 밝힙니다 [공식 문서].
한 줄로 줄이면, 비싸지만 안 물어본 걸 묻게 하는 도구입니다.
이번 실험의 한계
- 방식마다 한 번씩만 돌렸습니다. 녹화에서 보았듯 같은 모델도 매번 다르니 분산은 모릅니다.
- 760줄짜리 작은 앱입니다. 큰 저장소나 여러 사람이 함께 쓰는 프로젝트에서는 결과가 다를 수 있습니다.
- 사후 시험 2개는 공정한 사전 시험이 아닙니다. 반대 방향, 즉 EGM만 실패하는 시험은 이번에 찾지 못했지만 찾으려고 많이 시도한 것도 아닙니다.
- 미리 해 본 실험은 예산 때문에 Stage 9 지적을 처리하지 않고 끝냈습니다(Major 4건 미해결). Stage 5·6·8 지적도 확인된 결함 일부 말고는 대부분 처리하지 않았습니다. 다 처리했다면 비용은 더 들었을 것입니다.
- 설계 문서가 커지는 부작용도 봤습니다. 지적을 반영하다 1077줄이 1186줄로 늘었고, 단계마다 같은 지적이 반복되기도 했습니다.
- 앱을 사람이 충분히 써 보는 검수는 하지 않았습니다.
- 실험에 쓴 EGM은 0.1.0입니다. 활발히 바뀌는 저장소라 명령과 문서가 달라졌을 수 있습니다.
영상으로 보기
설치부터 구현까지 실제 실행 화면과 함께 정리했습니다.
출처
- google/elephant-goldfish-model: README, 설치 명령, 역할 설명, 라이선스 표기
- EGM 시작 안내, 검토 스킬
- Claude Code 플러그인 문서, 서브에이전트 문서, 권한 모드 문서